AI Bots Web Crawling: Cho Phép Hay Block Để Tăng AI Citations Trong 2026
6 tháng trước · 10 phút đọc
AI bots đang crawl web của bạn - và bạn chưa có chiến lược
Mở server log lên. Nếu bạn thấy GPTBot, ClaudeBot, hay PerplexityBot xuất hiện trong đó, bạn đang bị crawl bởi các AI company mỗi ngày - mà không nhận được gì đổi lại, trừ khi bạn chủ động tối ưu.
Hai năm trước, chuyện này không ai quan tâm. Search traffic từ Google là tất cả. Nhưng 2026 khác rồi: người dùng ngày càng hỏi ChatGPT, Perplexity, hay Claude thay vì Google. Nếu content của bạn không xuất hiện trong câu trả lời AI đó, bạn mất visibility - dù site vẫn rank tốt trên Google.
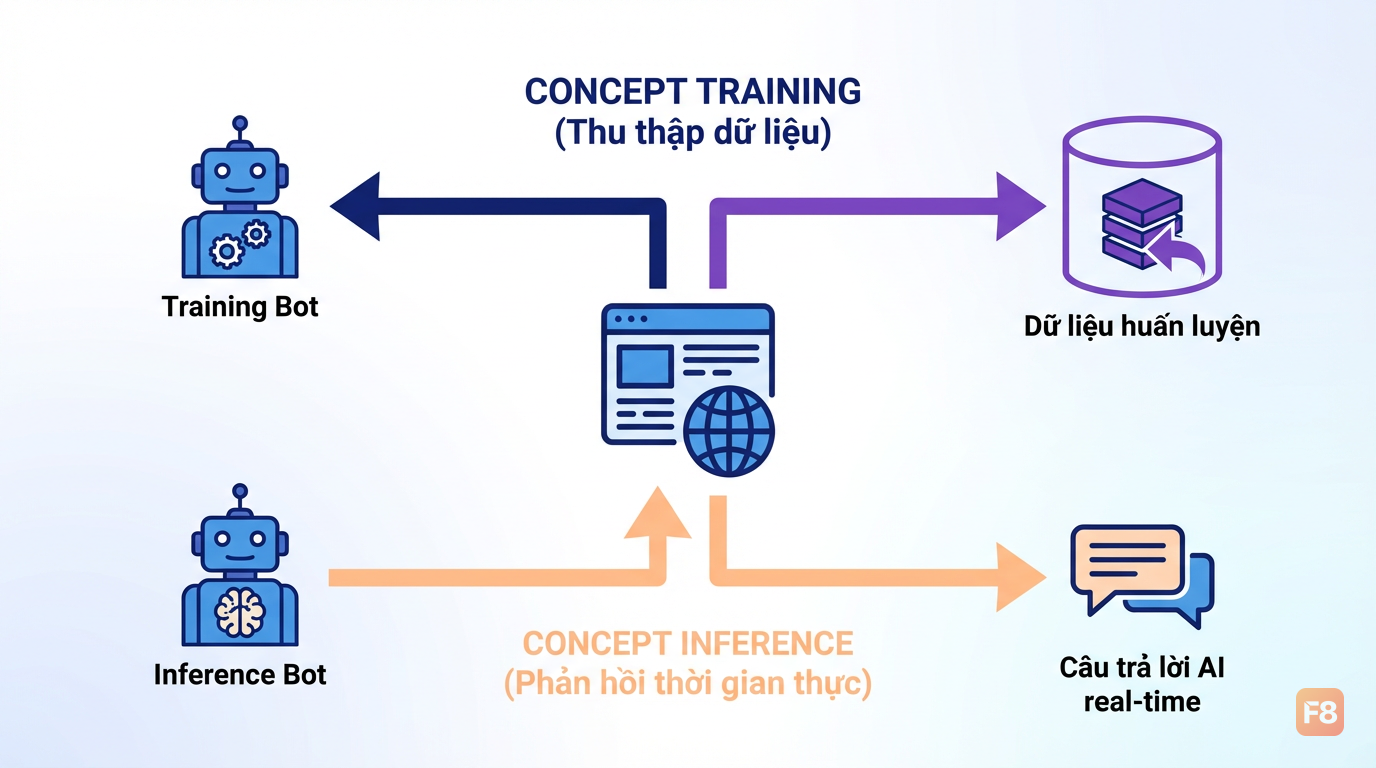 Bot crawl web theo 2 mục đích khác nhau: train model hoặc trả lời real-time
Vấn đề cốt lõi ở đây: không phải tất cả AI bots đều như nhau. Có loại crawl để train model (embedding content vĩnh viễn vào LLM), có loại crawl để trả lời real-time (fetch live data khi user hỏi). Quyết định allow hay block mà không phân biệt hai loại này là sai từ gốc. Bài này mình sẽ break down cụ thể từng loại bot, số liệu thực tế về blocking trends, và cách viết robots.txt hợp lý cho site của bạn.
Training bots vs inference bots: sự khác biệt quyết định tất cả
Đây là điều quan trọng nhất bài này muốn nói.
Training crawlers như GPTBot hay ClaudeBot thu thập dữ liệu để nhét vào model. Một khi content của bạn được train vào LLM, nó nằm đó mãi - bạn không thể lấy lại, không được credit, không có link back. Đây là lý do nhiều publisher chọn block.
Inference/retrieval crawlers hoạt động khác hoàn toàn. Khi user hỏi Perplexity hay ChatGPT Search một câu hỏi, bot này mới fetch live data từ web - và kết quả thường đi kèm citation có link về nguồn. Allow loại bot này = traffic thực + tên site xuất hiện trong AI answer.
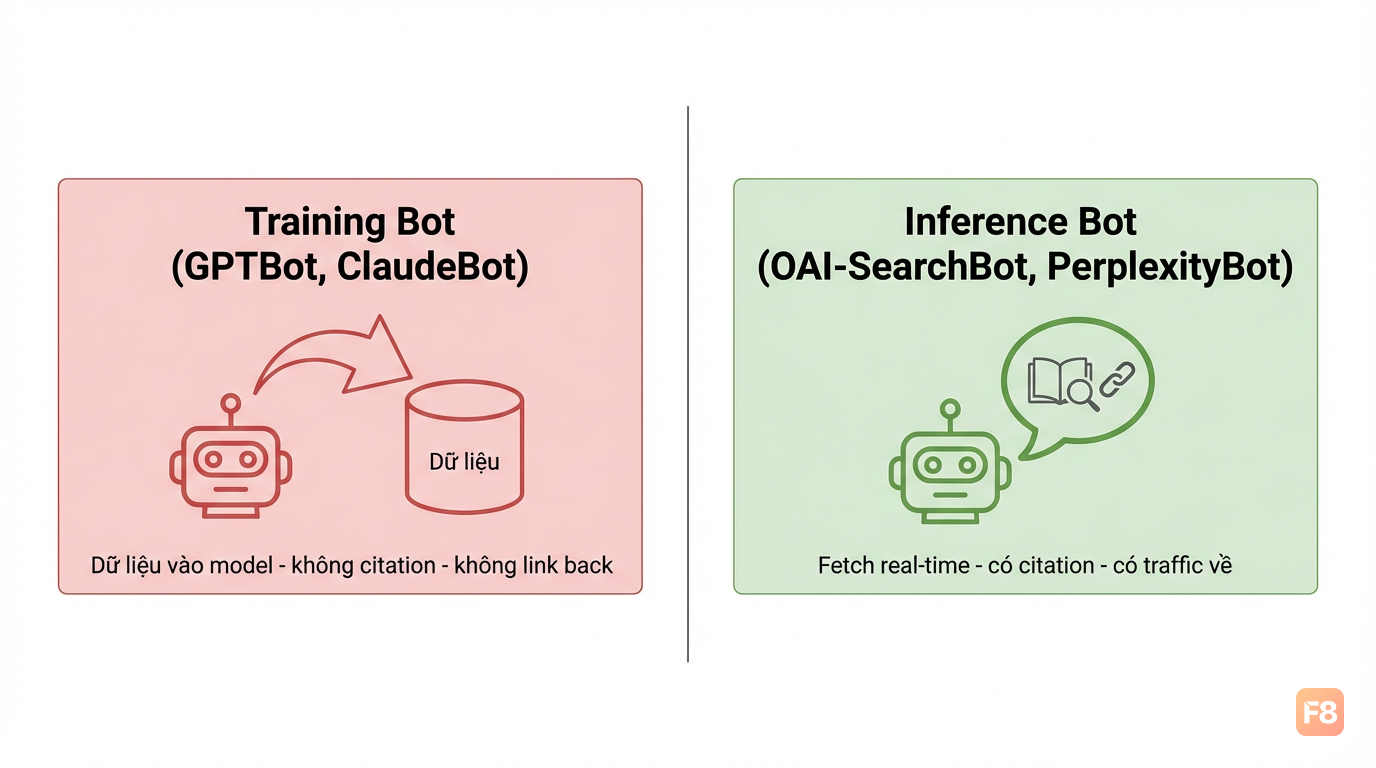 Allow inference bot mới có citation; training bot không mang lại gì trực tiếp
Dưới đây là breakdown các bot phổ biến nhất hiện tại:
| Bot | Công ty | Mục đích | Tỉ lệ bị block (news sites) |
|---|---|---|---|
| GPTBot | OpenAI | Training | 49.4% (BuzzStream research) |
| ClaudeBot | Anthropic | Training | 69% (BuzzStream’s analysis (via ALM Corp)) |
| PerplexityBot | Perplexity | Index/Retrieval | 67% (BuzzStream research (cited in almcorp.com)) |
| OAI-SearchBot | OpenAI | ChatGPT live search | 55.67% (Hostinger (via almcorp.com)) |
| Google-Extended | AI training (opt-out) | 46% (almcorp.com) |
Nhìn vào bảng này, bạn thấy gì? OAI-SearchBot bị block ít hơn GPTBot - và đó là dấu hiệu cho thấy nhiều site đã bắt đầu phân biệt hai loại. Nhưng Hơn 94% domain vẫn allow GPTBot mà không giới hạn gì - phần lớn là vì chủ site chưa biết bot đó tồn tại.
Xu hướng blocking thực tế và tại sao bạn nên quan tâm
Số liệu blocking bots thay đổi nhanh hơn bạn nghĩ.
Q1 2026, ClaudeBot vượt CCBot để trở thành bot bị block nhiều thứ hai sau GPTBot. Cloudflare thậm chí bắt đầu yêu cầu người dùng mới cấu hình crawler policy ngay khi sign up - không phải optional nữa. Đây là dấu hiệu rõ ràng: industry đã coi AI crawling là vấn đề infra, không còn là chuyện SEO phụ.
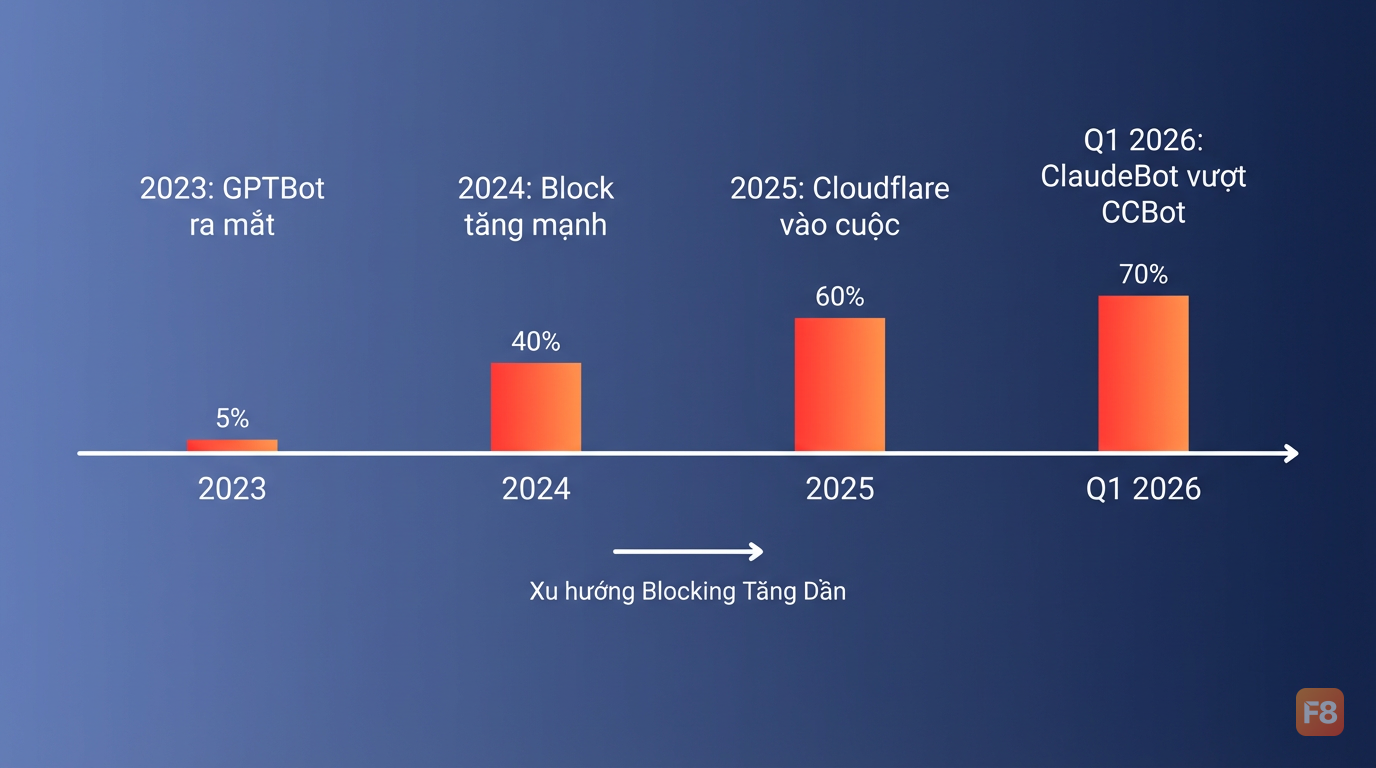 Blocking trend tăng dần nhưng vẫn chậm - phần lớn site chưa có policy rõ ràng
Nhưng nhìn từ góc khác: tốc độ tăng blocking vẫn chậm. GPTBot bị block trên 14% (Cloudflare Radar) domains - con số này tăng rất nhỏ so với năm trước, và projection cho thấy sẽ mất nhiều năm mới đạt 10% nếu tiếp tục đà này. Phần lớn web đang im lặng - và sự im lặng đó có nghĩa là allow mặc định.
Với dev Việt, đây là điểm thú vị: nếu bạn chủ động optimize trong khi người khác chưa làm gì, bạn có lợi thế sớm. Đặc biệt với content tiếng Việt - AI models đang thiếu dữ liệu chất lượng tiếng Việt, nên content của bạn có giá trị hơn bạn nghĩ với các inference bots.
Nhìn thực tế: 71% news sites top block retrieval bots vì sợ AI summary lấy hết traffic. Nhưng 18% lại allow tất cả để tăng visibility. Không có đáp án đúng tuyệt đối - phụ thuộc vào model kinh doanh của bạn.
Viết robots.txt thông minh: block training, allow citations
Đây là phần thực hành. Mình sẽ đi thẳng vào code.
Nguyên tắc chung: block training bots, allow inference bots trên public content. Đây là cân bằng hợp lý nhất cho phần lớn dev site, blog tech, hay e-commerce Việt.
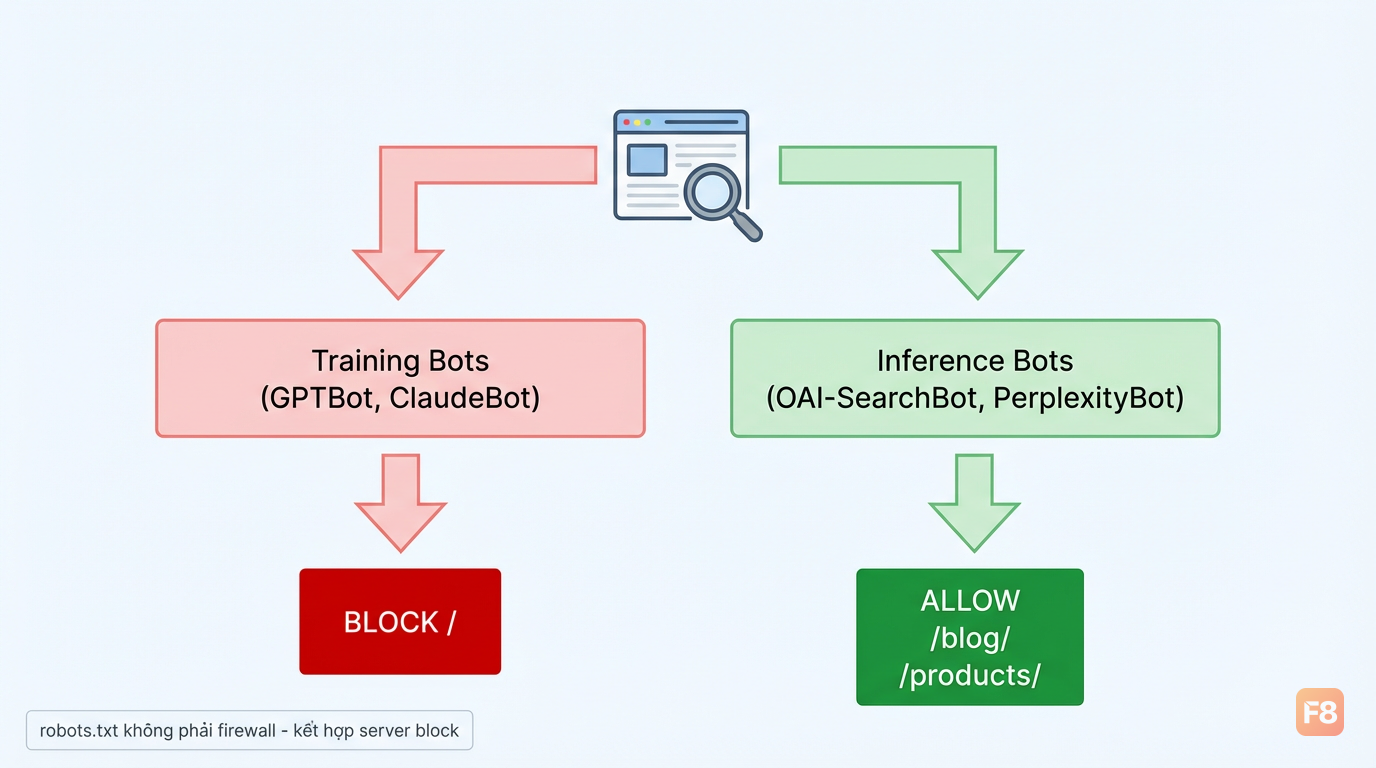 Block training, allow inference - đây là pattern phổ biến nhất 2026
Một vài lưu ý quan trọng khi áp dụng:
Robots.txt không phải firewall. Các bot lớn như GPTBot hay ClaudeBot của OpenAI và Anthropic đều cam kết honor robots.txt - nhưng đó là cam kết tự nguyện. Bot từ công ty nhỏ hơn hoặc scraper không tên thì không đảm bảo. Nếu muốn chắc chắn, cần thêm server-level blocking qua Nginx hay Cloudflare.
User-agent string thay đổi theo thời gian. Ví dụ, OAI-SearchBot là user-agent mới của OpenAI cho ChatGPT Search - khác với GPTBot. Bạn cần check danh sách user-agent AI bots cập nhật định kỳ để cập nhật list.
Selective path blocking hoạt động tốt nhất cho e-commerce: allow /blog/ và /products/ cho inference bots, block /checkout/, /account/, /api/ hoàn toàn.
Generative Engine Optimization (GEO): bước tiếp theo sau robots.txt
Robots.txt là tầng đầu tiên. Muốn thực sự tối ưu cho AI citations, bạn cần biết đến GEO - Generative Engine Optimization.
GEO là tập hợp practices để site của bạn được trích dẫn nhiều hơn trong câu trả lời của AI. Khái niệm còn mới, chưa có chuẩn thống nhất, nhưng một số pattern đã bắt đầu nổi lên rõ ràng.
LLMs.txt là file mình thấy đáng thử nhất. Tương tự robots.txt nhưng dành riêng cho LLMs - bạn mô tả site của mình, cấu trúc nội dung, và những gì bạn muốn AI biết về site. Đặt ở root: yoursite.com/llms.txt. Một số inference bots đã bắt đầu đọc file này.
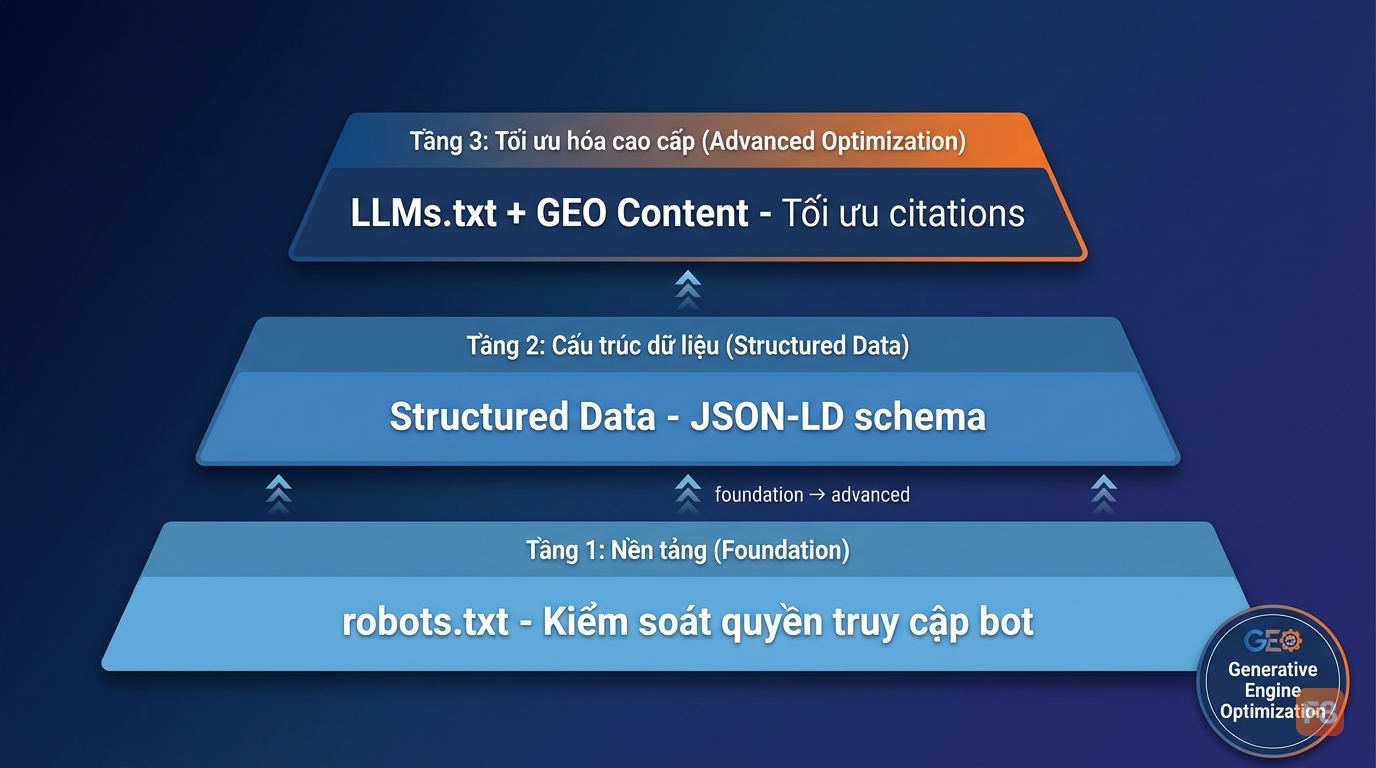 GEO là lớp tối ưu tiếp theo sau robots.txt - còn mới nhưng đáng đầu tư sớm
Structured data (JSON-LD) cũng giúp inference bots parse nội dung chính xác hơn. Nếu bạn viết tutorial, dùng HowTo schema. Nếu là bài review, dùng Review schema. AI models đọc structured data tốt hơn plain HTML.
Nội dung dạng Q&A tự nhiên được cite nhiều hơn. Người dùng hỏi AI câu hỏi - nếu content của bạn đã có format câu hỏi + trả lời ngắn gọn rõ ràng, khả năng được trích dẫn cao hơn hẳn so với prose dài.
Một điểm cần thực tế: GEO vẫn đang trong giai đoạn thử nghiệm. Không có ai biết chắc thuật toán ranking của từng AI model. Nhưng những pattern trên có logic rõ ràng và chi phí áp dụng thấp - nên làm sớm vẫn tốt hơn chờ đợi.
Nếu bạn muốn hiểu sâu hơn về cách server và backend của mình xử lý bot traffic, tối ưu API response hay cấu hình Nginx, khóa Node & ExpressJS trên F8 cover khá nhiều phần backend foundation hữu ích làm nền cho những setup này.
Checklist thực hành cho dev Việt: từ robots.txt đến server block
Tóm gọn lại những gì bạn cần làm - theo thứ tự ưu tiên.
Bước 1: Audit server log ngay hôm nay. Mở log, search các user-agent như GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot. Biết bot nào đang crawl trước khi quyết định gì.
Bước 2: Cập nhật robots.txt theo template ở trên. Block training bots, allow inference bots trên /blog/ và public content. Commit lên production trong vòng 30 phút.
Bước 3: Thêm server-level block nếu cần. Nếu dùng Cloudflare, vào dashboard → Security → Bots để toggle từng loại. Nếu dùng Nginx, thêm block theo user-agent string. Đây là layer bảo vệ thật sự, không phụ thuộc vào sự tự nguyện của bot.
Bước 4: Thêm LLMs.txt và xem xét structured data. Tạo file llms.txt ở root với mô tả ngắn về site. Review JSON-LD schema trên các trang quan trọng.
Bước 5: Monitor định kỳ mỗi tháng. User-agent strings thay đổi, chính sách của các AI company thay đổi. Tải checklist bên dưới để track.
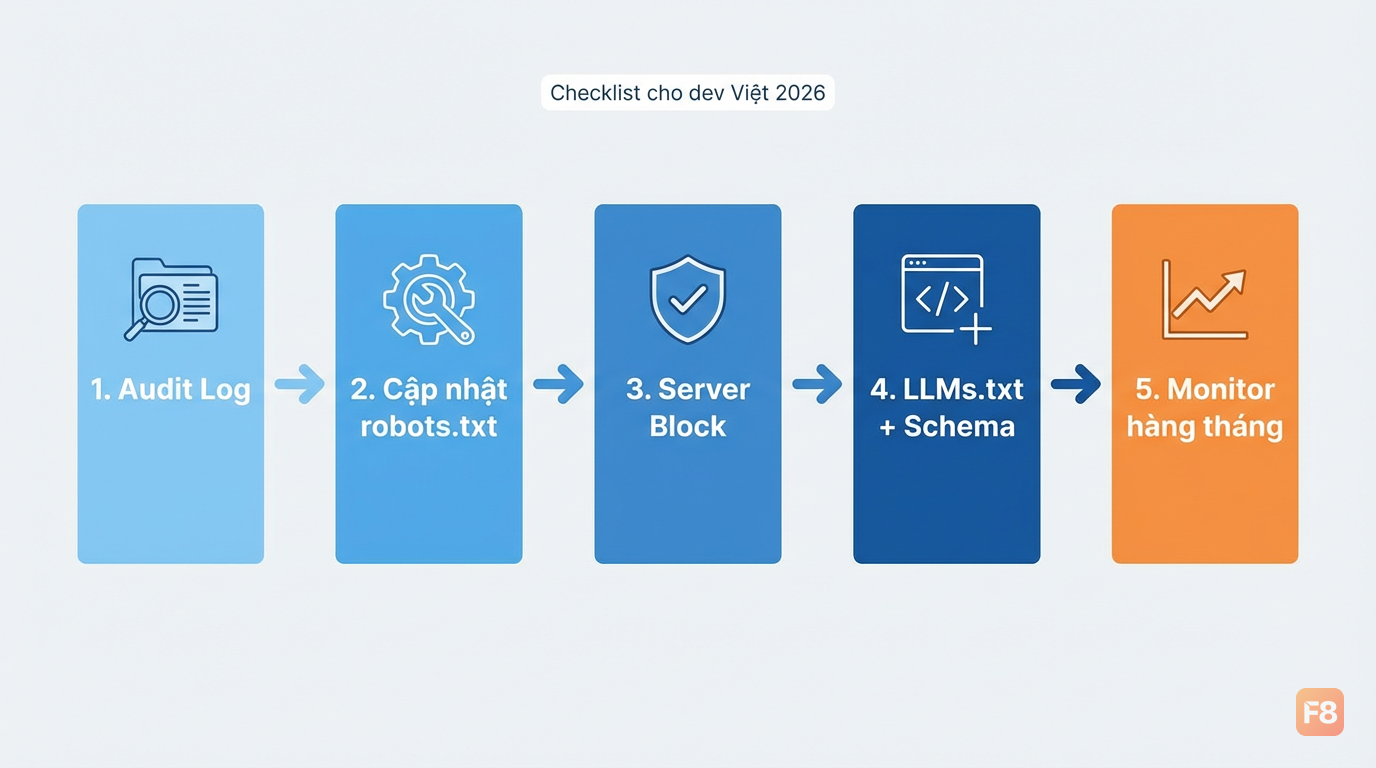 5 bước từ audit log đến GEO - làm theo thứ tự, không bỏ bước nào
Tải checklist đầy đủ tại đây: Tải AI Bot Management Checklist
Cuối cùng, một góc nhìn thực tế: không có setup nào là hoàn hảo vĩnh viễn. AI crawling landscape đang thay đổi nhanh hơn bất kỳ phần nào khác của web ecosystem. Cái bạn cần là policy rõ ràng hôm nay + habit review định kỳ - thay vì chờ đợi một giải pháp hoàn hảo chưa tồn tại.
Takeaways:
- Block training bots (GPTBot, ClaudeBot) để bảo vệ IP
- Allow inference bots (OAI-SearchBot, PerplexityBot) trên public content để có citations
- robots.txt là điểm bắt đầu, không phải điểm kết thúc
- GEO (LLMs.txt + structured data) là lớp tối ưu tiếp theo
Nếu bạn đã setup xong và muốn chia sẻ kết quả, drop comment. Mình đặc biệt tò mò về kết quả của site tiếng Việt - loại content đang thiếu trong hầu hết AI models hiện tại.