Conversational UI Design 2026: Xây AI Chat Interfaces Như ChatGPT Cho Web Việt
5 tháng trước · 13 phút đọc
Conversational UI không còn là trend - nó đã là tiêu chuẩn
Mình nhớ hồi 2022, thêm chatbot vào web nghĩa là nhúng widget từ Intercom hoặc Drift, setup vài cái canned response, xong. Người dùng hỏi câu gì không có trong kịch bản thì bot trả lời "Xin lỗi, mình không hiểu" rồi im lặng luôn.
Giờ thì khác hoàn toàn.
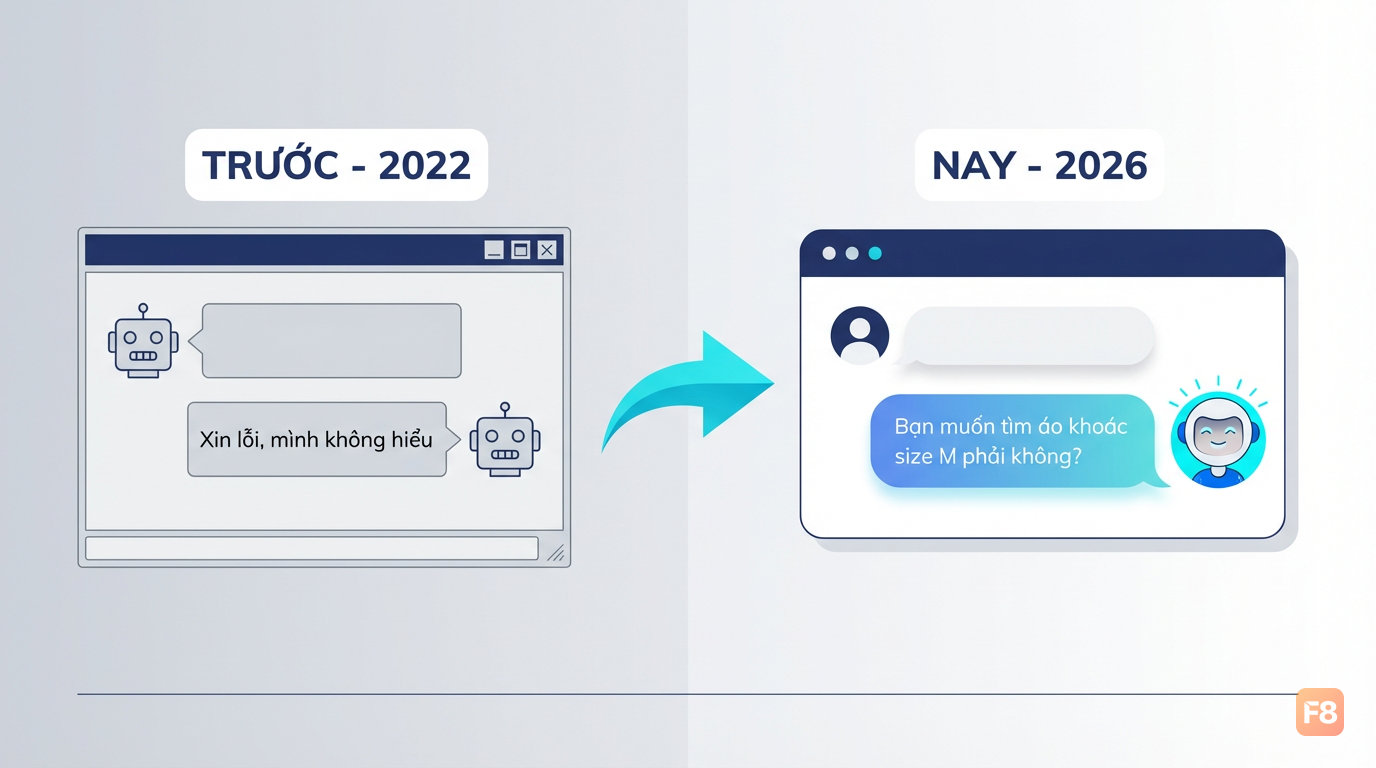 Từ bot kịch bản cứng sang AI chat tự nhiên - khoảng cách lớn hơn bạn nghĩ
Generative AI đang chạy phía sau {{fact:fact_0}} các sản phẩm conversational AI trên thị trường. Điều này có nghĩa gì với developer Việt? Nghĩa là người dùng đang ngày càng kỳ vọng chat interface thực sự hiểu họ, không phải đọc menu rồi bấm nút.
Bài này mình sẽ đi qua toàn bộ pipeline: từ thiết kế dialog flow, implement chat UI với JavaScript, đến integrate với LLM APIs - tất cả trong ngữ cảnh web Việt Nam.
Anatomy của một conversational UI tốt
Trước khi code, phải hiểu cái gì làm nên chat interface thực sự tốt. Không phải màu sắc, không phải animation đẹp.
Dialog management là não của toàn bộ hệ thống. Nó không xử lý từng câu hỏi độc lập - nó nhớ toàn bộ cuộc trò chuyện, hiểu khi người dùng đổi chủ đề giữa chừng, và không bị lạc khi câu trả lời đến sau 3 tin nhắn sau.
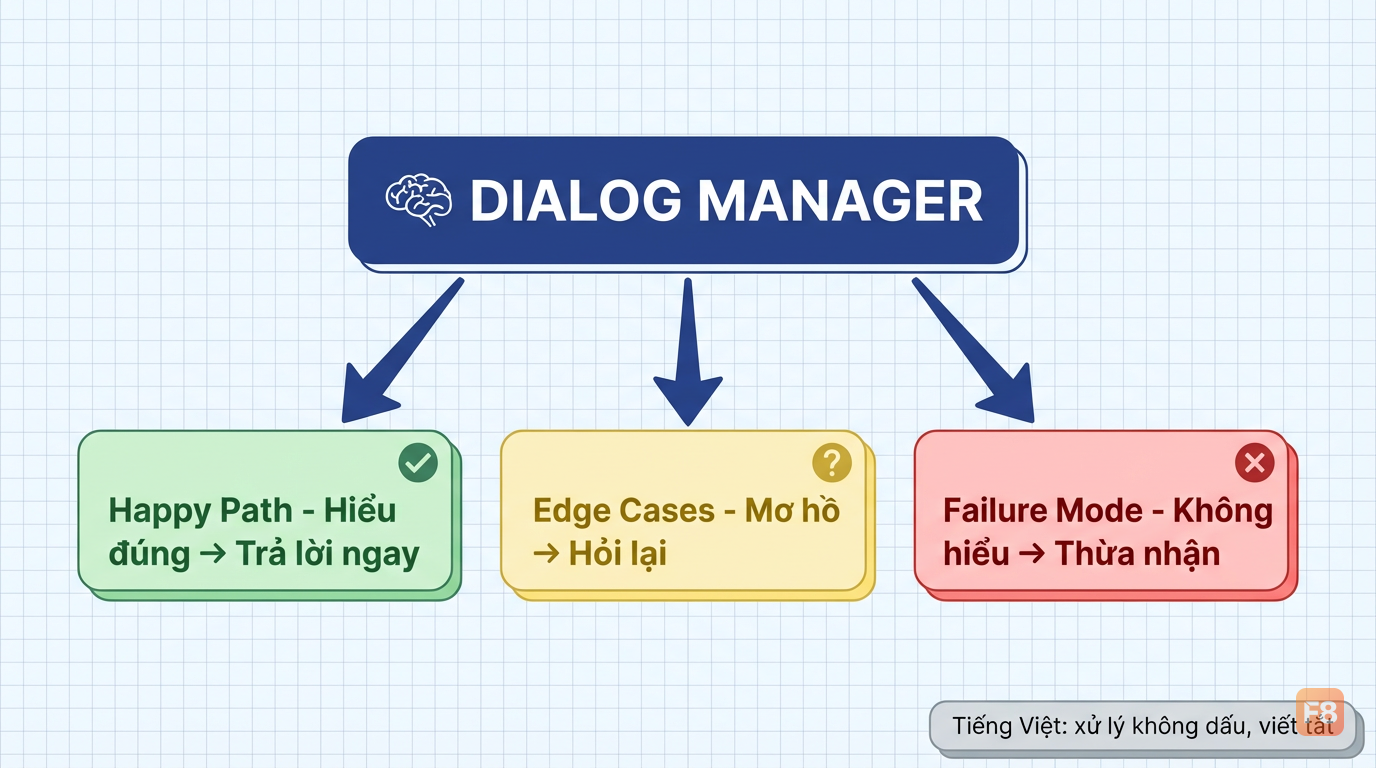 Dialog management giữ "ký ức" của toàn cuộc chat - đây là điểm khác biệt lớn nhất
Một hệ thống tốt cần cover 3 đường đi:
- Happy path: người dùng hỏi rõ, bot hiểu đúng, trả lời ngay
- Edge cases: câu hỏi mơ hồ, thiếu context - bot phải hỏi lại thay vì đoán
- Failure modes: bot không hiểu - phải thừa nhận và offer alternative thay vì im lặng hoặc trả lời lạc đề
Trong thực tế, 80% effort của conversation design nằm ở edge cases và failure modes. Happy path thì ai cũng làm được.
Với tiếng Việt, thêm một lớp phức tạp nữa: cùng một từ có thể mang nghĩa khác nhau tùy vùng miền, cách viết tắt và không dấu rất phổ biến ("ko" thay "không", "đc" thay "được"). Dialog manager phải xử lý được những pattern này. Test thực tế với người dùng Việt trước khi đưa lên production - đây là bước mà hầu hết team bỏ qua.
Xây chat UI với JavaScript thuần - bắt đầu đơn giản
Nhiều người nhảy thẳng vào React, Vercel AI SDK, LangChain.js ngay từ đầu. Mình khuyên ngược lại: hiểu cơ chế streaming response với JavaScript thuần trước, sau đó mới đưa abstraction layer vào.
Dưới đây là skeleton của một chat interface tích hợp LLM API:
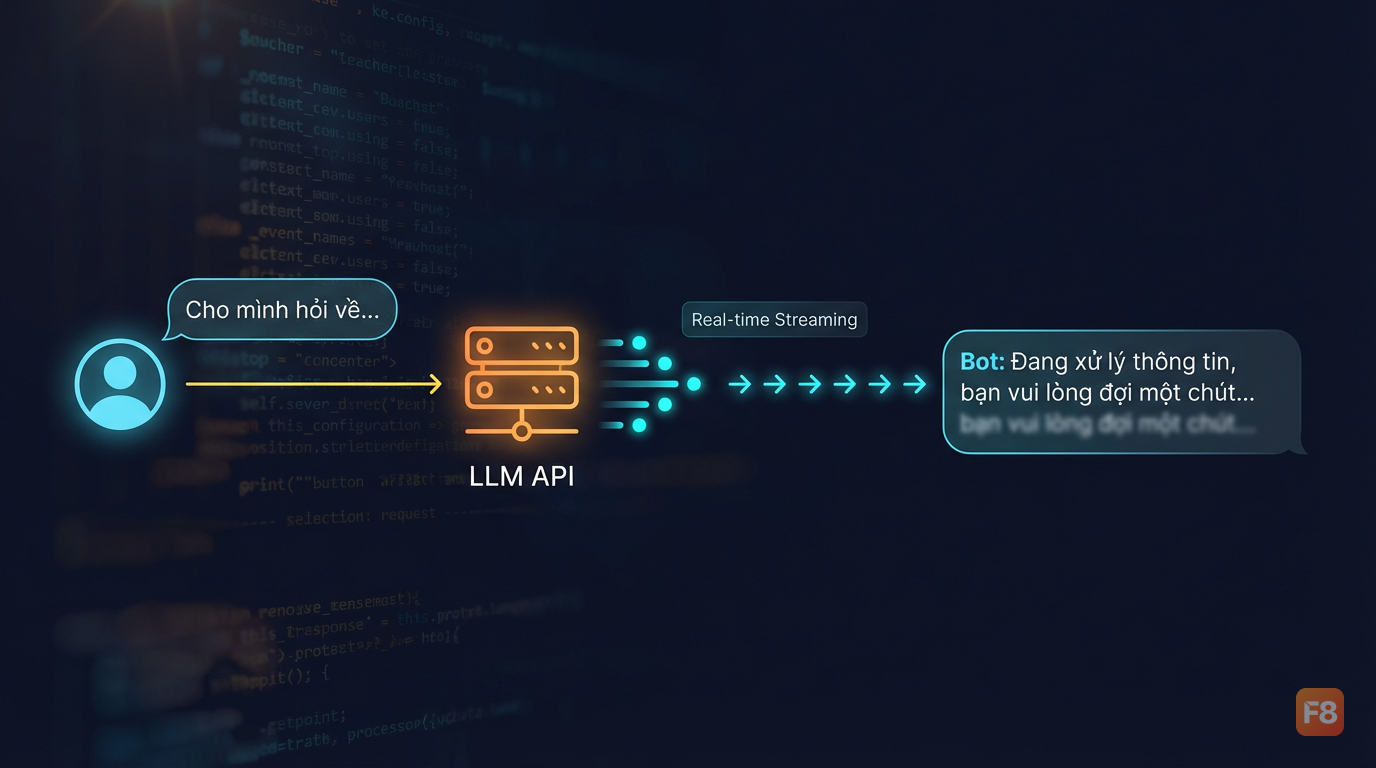 Streaming response tạo cảm giác "đang suy nghĩ" - giữ người dùng ở lại thay vì chờ trắng
Mấy điểm quan trọng trong đoạn code trên:
conversationHistory array là cái giữ context cho toàn bộ cuộc trò chuyện. Mỗi lần gọi API, bạn gửi toàn bộ lịch sử lên - đây là cách LLM "nhớ" được những gì đã nói. Nhược điểm? Token tốn gấp đôi theo thời gian. Cần có logic truncate khi history quá dài.
Streaming không phải chỉ để đẹp. Nó thực sự giữ người dùng ở lại - thấy text xuất hiện dần thì khác hẳn nhìn spinner quay 3 giây rồi đùng một phát hiện cả đoạn.
Nếu bạn chưa vững JavaScript, khóa Lập Trình JavaScript Nâng Cao có cover async/await, streams và các pattern cần thiết để hiểu đoạn code này.
Tích hợp LLM API: những thứ cần biết trước khi bắt đầu
Bạn có 3 lựa chọn chính hiện tại: OpenAI GPT, Anthropic Claude, và Google Gemini. Tất cả đều support tiếng Việt ở mức chấp nhận được - nhưng chất lượng thực tế cần bạn tự test với dataset tiếng Việt của mình.
Không có API nào "tốt nhất cho tiếng Việt" theo kiểu tuyệt đối. Mình nói thẳng vậy vì thấy nhiều bài blog khẳng định chắc chắn mà không có benchmark thực tế. Cách duy nhất là tự test với use case cụ thể của bạn.
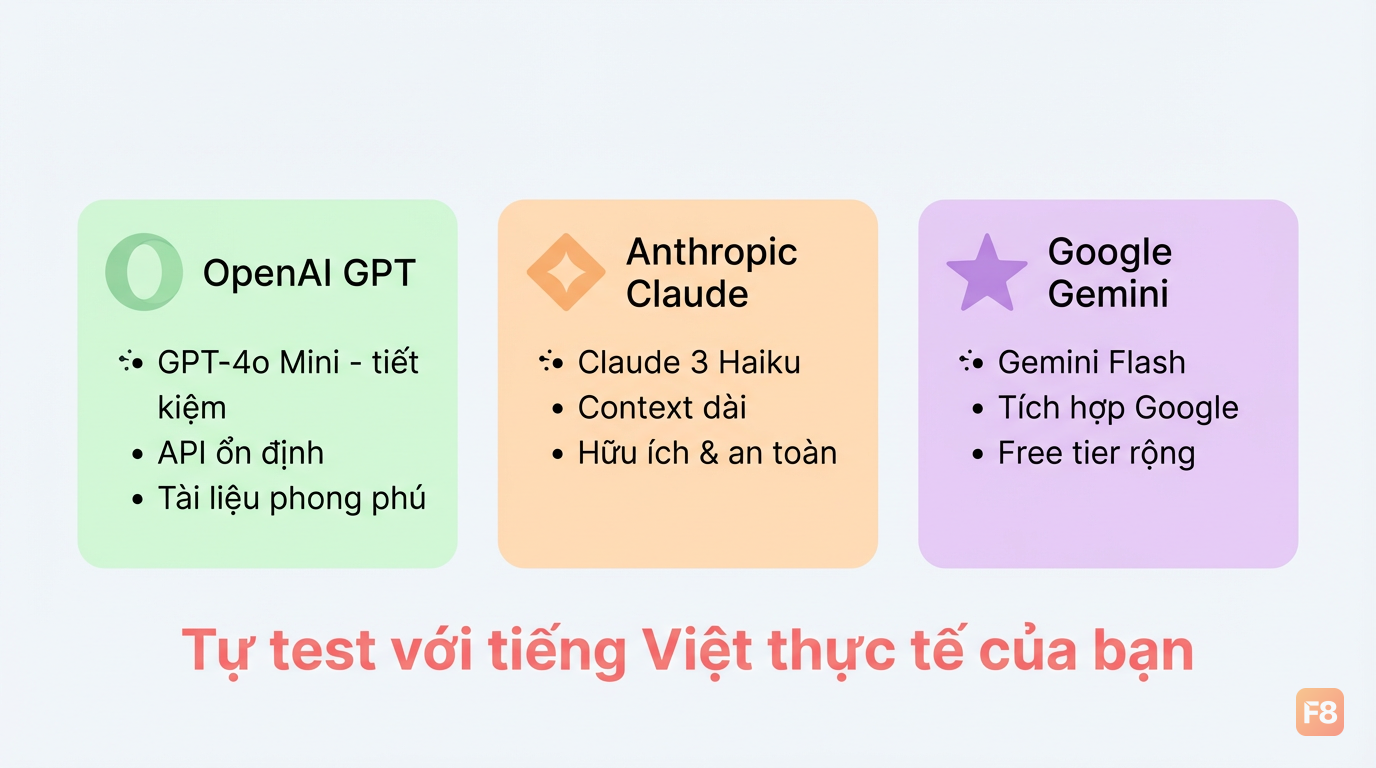 Ba nhà cung cấp LLM chính - so sánh tính năng, không phải chất lượng tiếng Việt (cần tự test)
Phần backend Node.js để call API một cách an toàn:
Vài điểm mà mình thấy team hay bỏ sót:
Kiểm soát chi phí trước khi launch. trimmedMessages và max_tokens không phải optional - là mandatory. Mình từng thấy project bị hóa đơn $200 trong tuần đầu tiên vì quên set limit.
Rate limiting phía server. Nếu không có, một người dùng có thể spam API và đốt hết quota của bạn. Implement rate limit theo IP hoặc user ID.
System prompt là nơi bạn "lập trình" tính cách bot. Với web Việt, thêm instruction cụ thể: trả lời tiếng Việt tự nhiên, dùng "bạn/mình" thay vì formal, hiểu viết tắt phổ biến.
Dynamic personalization: làm chat interface "biết" người dùng
Context-aware design không phải gọi API mỗi tin nhắn và hi vọng LLM nhớ. Bạn cần chủ động inject context vào system prompt.
Ví dụ thực tế với e-commerce Việt:
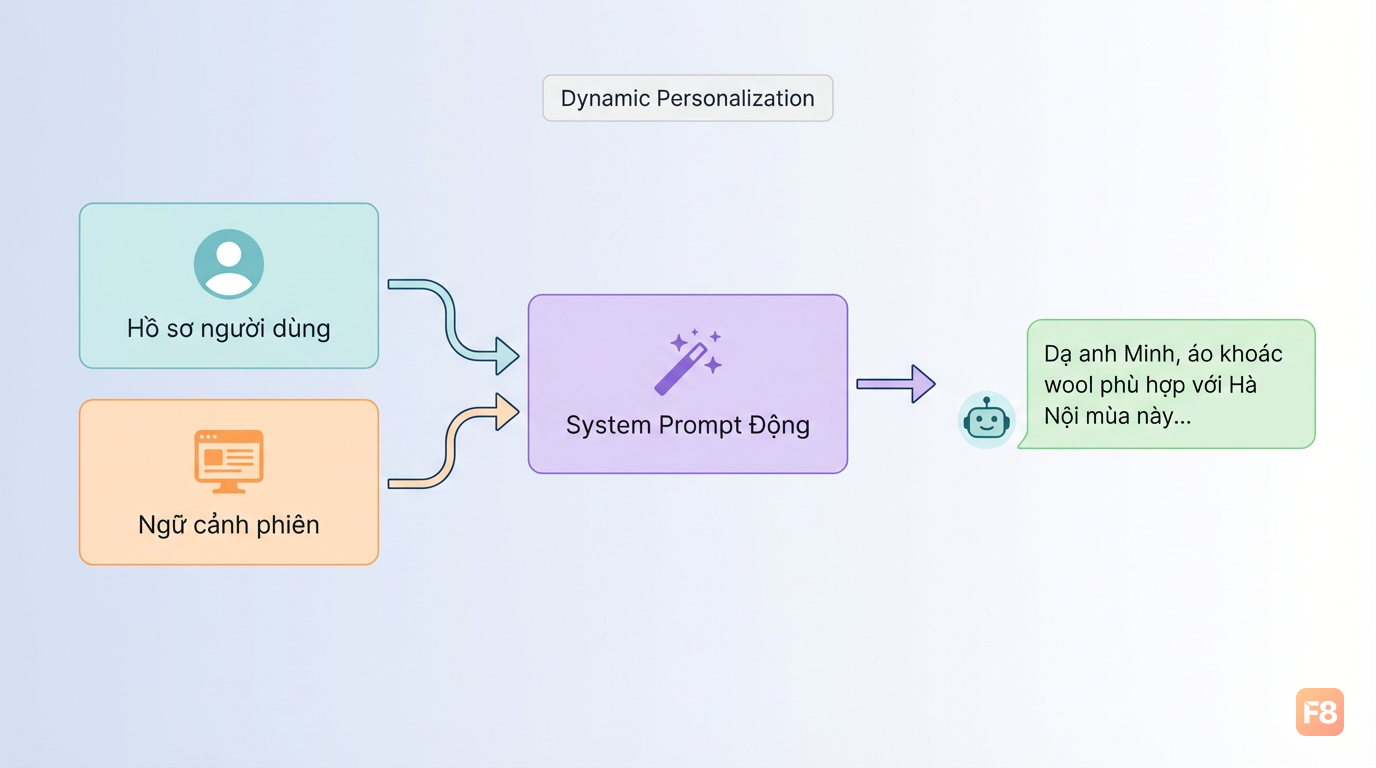 Inject context vào system prompt = bot "biết" người dùng mà không cần fine-tuning
Kết quả? Với cùng câu hỏi "Áo nào phù hợp với mình?", bot sẽ trả lời khác nhau cho người dùng ở Hà Nội đang xem áo khoác mùa đông và người dùng ở TP.HCM vừa mua áo thun. Đây là dynamic personalization thực sự - không phải chỉ gọi tên người dùng trong câu chào.
Thị trường emotional AI đang được dự báo đạt {{fact:fact_1}} vào năm 2026. Nhưng với web Việt hiện tại, personalization context-aware như trên đã là bước nhảy vọt so với chatbot cứng.
Vấn đề privacy: Bạn đang gửi data người dùng lên LLM API. Cần có consent rõ ràng trong privacy policy, và nên anonymize những thông tin nhạy cảm. Đây không phải optional - là yêu cầu pháp lý.
Clear prompts và UX pattern: thiết kế để người dùng biết phải làm gì
Một trong những lỗi phổ biến nhất mình thấy: developer build xong chat interface, đặt placeholder "Nhập tin nhắn..." rồi thôi. Người dùng mở ra nhìn, không biết chat được gì, đóng lại.
Prompt suggestion là thứ giải quyết vấn đề này. Không phải câu hỏi gợi ý chung chung - mà phải cụ thể theo context:
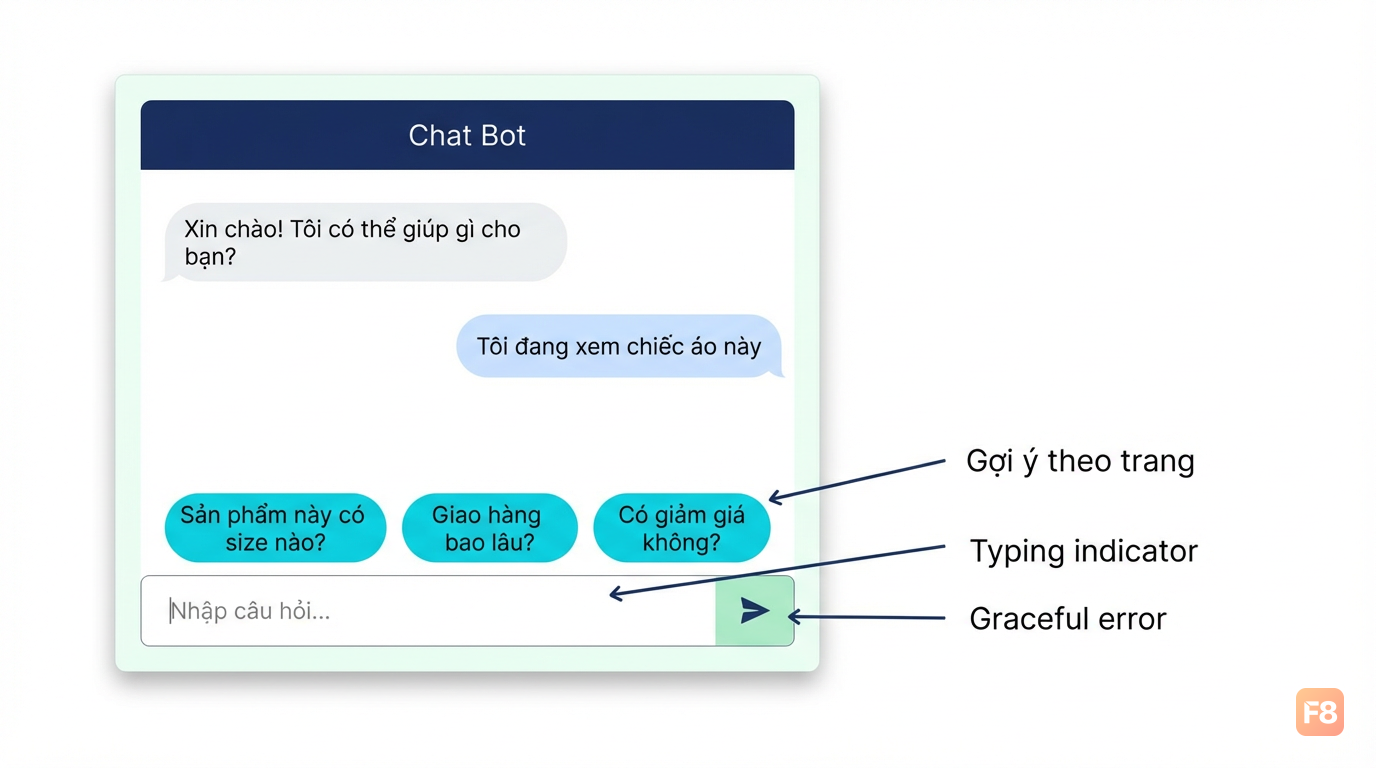 Suggestion chips đúng context giảm ma sát - người dùng không phải nghĩ mình cần hỏi gì
Ngoài suggestion chips, còn vài UX pattern quan trọng:
Typing indicator (3 chấm nhấp nháy) trong khi bot đang xử lý. Không có cái này, người dùng không biết bot đang làm gì hay đã crash.
Graceful degradation: khi API call fail, không hiển thị lỗi kỹ thuật. Thay bằng: "Mình đang bận chút, thử lại sau vài giây nhé!" kèm nút Thử lại.
Character limit indicator nếu bạn cap input. Người dùng Việt hay viết dài - đừng để họ submit xong mới biết bị cắt.
Muốn tạo UI đẹp cho chat interface? Tải demo interactive bên dưới để xem một implementation hoàn chỉnh với suggestion chips, typing indicator và error handling:
{{resource:resource_1}}
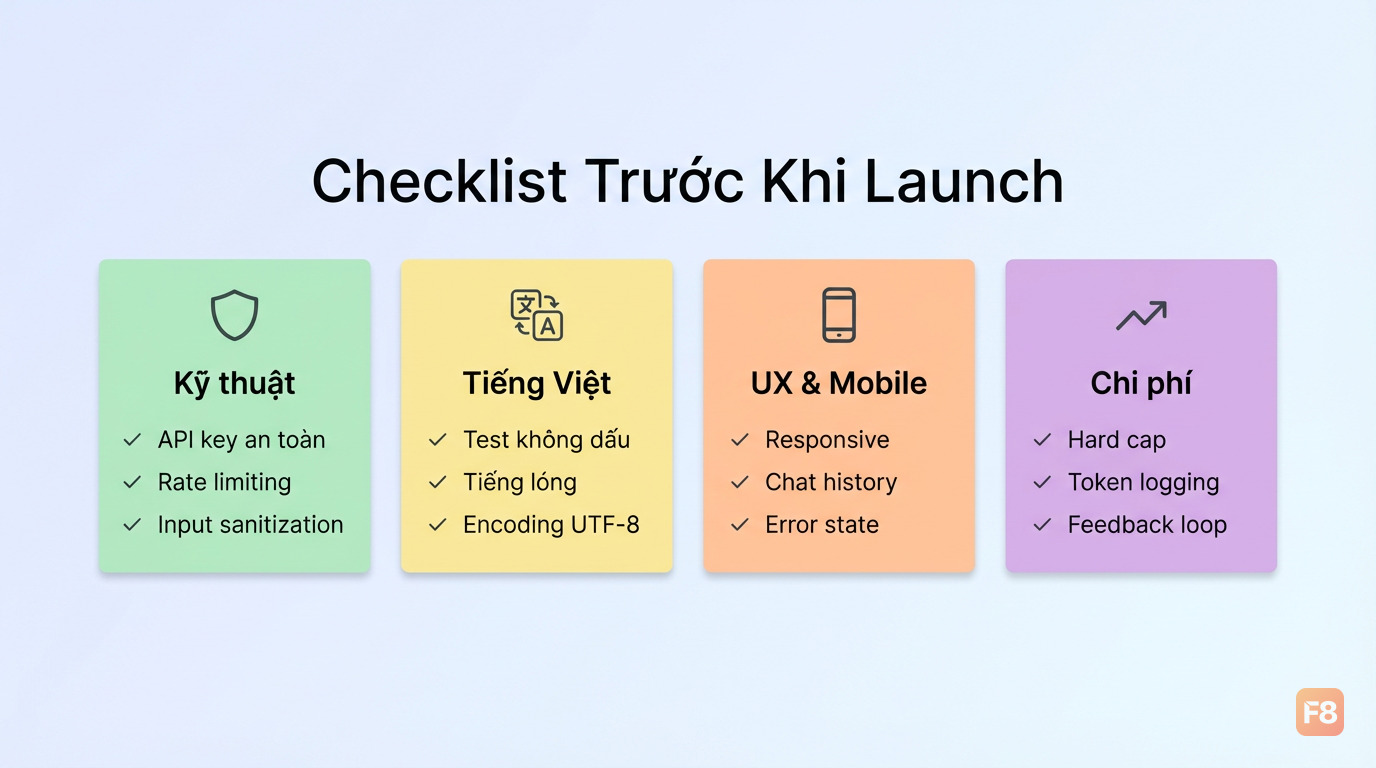
Từ prototype đến production: checklist trước khi launch
Có code chạy được trên localhost khác xa có chat interface production-ready. Đây là những gì cần check trước khi cho người dùng Việt thật sử dụng:
Về kỹ thuật:
- API key được lưu trong environment variables, không trong code
- Rate limiting theo IP: giới hạn số request mỗi phút
- Input sanitization: người dùng có thể nhập HTML, SQL injection attempt vào chat box
- Conversation history được store phía server, không chỉ localStorage (người dùng clear browser là mất hết)
- Fallback khi LLM API down: không để người dùng thấy trang trắng
Về tiếng Việt:
- Test với văn không dấu ("ban co the giup minh khong")
- Test với tiếng lóng phổ biến hiện tại
- Test với câu pha tiếng Anh ("chat interface này có support dark mode không?")
- Kiểm tra encoding UTF-8 suốt pipeline - từ input đến API response đến storage
 Không test với user thật thì không biết bot nói gì - đặc biệt với tiếng Việt đa dạng vùng miền
Về UX:
- Mobile responsive: {{fact:fact_2}} người dùng internet Việt Nam truy cập từ điện thoại
- Chat history persist giữa các session
- Nút clear conversation rõ ràng
- Thông báo khi đang maintain hoặc API có vấn đề
Về chi phí và monitoring:
- Set hard cap trên OpenAI dashboard (Usage Limits)
- Log mọi API call với token count để track chi phí
- Alert khi daily spend vượt threshold
- Có cơ chế feedback (thumbs up/down) để biết bot đang trả lời tốt hay không
Launch nhỏ trước. Thả cho 50-100 người dùng thật dùng thử, đọc conversation logs, fix những chỗ bot nói sai hoặc không hiểu. Mình thấy đây là bước mà hầu hết team skip - và thường hối hận sau đó.
Giờ bạn đã có đủ để bắt tay vào làm. Bước tiếp:
- Tải demo HTML về, chạy và tìm hiểu cách typing indicator và suggestion chips hoạt động
- Setup một backend Node.js đơn giản với endpoint
/api/chatvà test call LLM API thủ công - Thêm context vào system prompt dựa trên data người dùng bạn đang có
- Test với 5 người dùng thật - ít nhất 1 người từ miền Bắc, 1 miền Nam
Gặp vướng mắc ở bước nào, drop comment bên dưới.
Tài nguyên để đọc thêm: {{resource:resource_2}}