Gemini API vs Claude API: Xây Chatbot AI Thông Minh Cho Web Việt 2026
7 tháng trước · 7 phút đọc
Mở đầu: build nhanh, ngân sách mỏng
Mình từng ship một chatbot hỗ trợ khách hàng cho một shop online chỉ trong cuối tuần. Yêu cầu rất Việt Nam: tiếng Việt tự nhiên, rẻ, phản hồi nhanh, cắm vào web hiện có. Lúc test, Gemini trả lời thân thiện, Claude giữ ngữ điệu chắc chắn hơn. Câu hỏi đặt ra: chọn API nào cho 2026 để tối ưu chi phí và hiệu suất?
Thực tế, 80% câu hỏi lặp lại: vận chuyển, đổi trả, bảo hành. Vấn đề ở đâu? Triển khai chậm ở khâu kiến trúc và cost control chứ không phải model. Bài này mình đi thẳng vào so sánh khác biệt, kiến trúc tiết kiệm, và code mẫu cắm ngay vào web.
 Mục tiêu: phản hồi nhanh, chi phí ổn, dễ tích hợp
Key insight: chọn model là bước 1. Bước 2 mới là nơi tiết kiệm tiền thật: cache, streaming, fallback thông minh.
Gemini vs Claude: điểm khác cần biết năm 2026
Điểm mấu chốt là ngữ cảnh lớn, chất lượng tiếng Việt, và công cụ hỗ trợ như JSON mode, function calling, streaming. Gemini thường mạnh về tốc độ và multimodal. Claude nổi bật ở reasoning và tuân thủ cấu trúc. Chọn sai sẽ tốn tiền ở mỗi lượt hội thoại.
- Ngữ cảnh: Gemini công bố ngữ cảnh tối đa đạt 2 million tokens (Gemini 2.5 Pro) (Google AI for Developers - Gemini API Changelog). Claude có cấu hình ngữ cảnh tối đa khoảng 1,000,000 tokens - Claude Sonnet 4 (with context-1m-2025-08-07 beta header) (AWS & Anthropic Official Documentation). Ngữ cảnh càng lớn càng tiện RAG, nhưng chi phí token tăng theo.
- Giá: Input 1M tokens của Gemini khoảng $1.25 per 1M input tokens (for prompts ≤200k tokens); $2.50 per 1M input tokens (for prompts >200k tokens) (Google Gemini Developer API pricing (ai.google.dev)); Claude khoảng mức tương đương các model cao cấp. Đây là điểm quyết định với site có nhiều truy vấn dài.
- Tiếng Việt: Cả hai đáp ứng tốt. Khác biệt nằm ở tone: Gemini mềm hơn, Claude chặt chẽ hơn. Lợi ích? Dễ khớp brand voice nếu có prompt chuẩn.
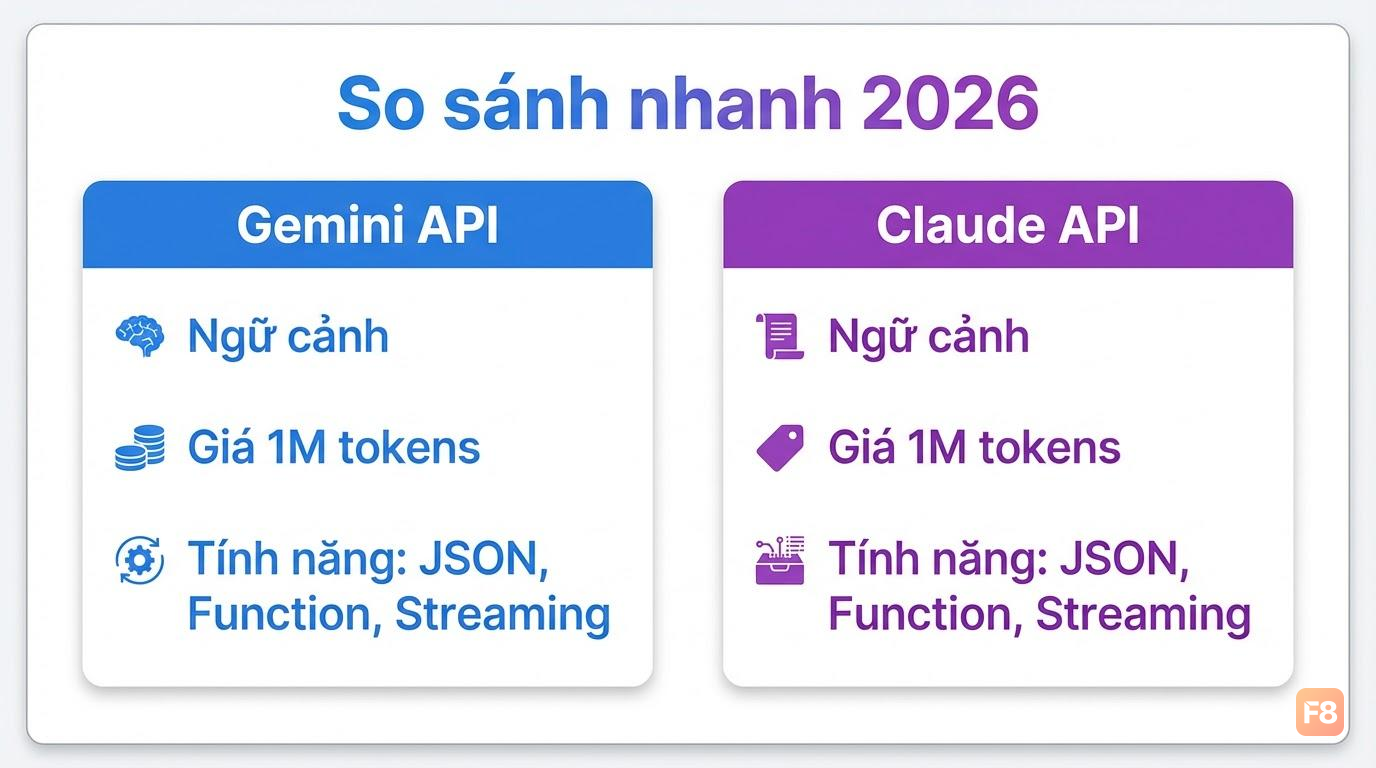 So sánh nên đi vào tiêu chí ảnh hưởng chi phí thật
Trade-off: model rẻ hơn có thể tăng lượt fallback và vòng lặp hỏi lại. Remedy: ép JSON mode cho answer types cố định và log tỷ lệ “không tự tin” để tối ưu prompt.
Kiến trúc tiết kiệm: cache + rerank + fallback
Bạn muốn hóa đơn nhẹ mà câu trả lời vẫn chuẩn. Cách mình hay dùng: cache câu hỏi phổ biến, RAG gọn nhẹ, rerank trước khi gửi LLM, và fallback giữa 2 nhà cung cấp khi gặp rate limit hoặc confidence thấp.
Luồng chuẩn:
- Web widget gửi request về backend. Backend chuẩn hóa ngôn ngữ, kiểm tra cache theo intent. Nếu trúng, trả ngay.
- Không trúng: lấy context ngắn từ vector DB, rerank để giữ 3-5 đoạn phù hợp nhất, gọi LLM với streaming.
- Thấp tự tin: fallback sang model kia hoặc gửi câu hỏi phụ để làm rõ. Log toàn bộ cost/token để tối ưu định kỳ.
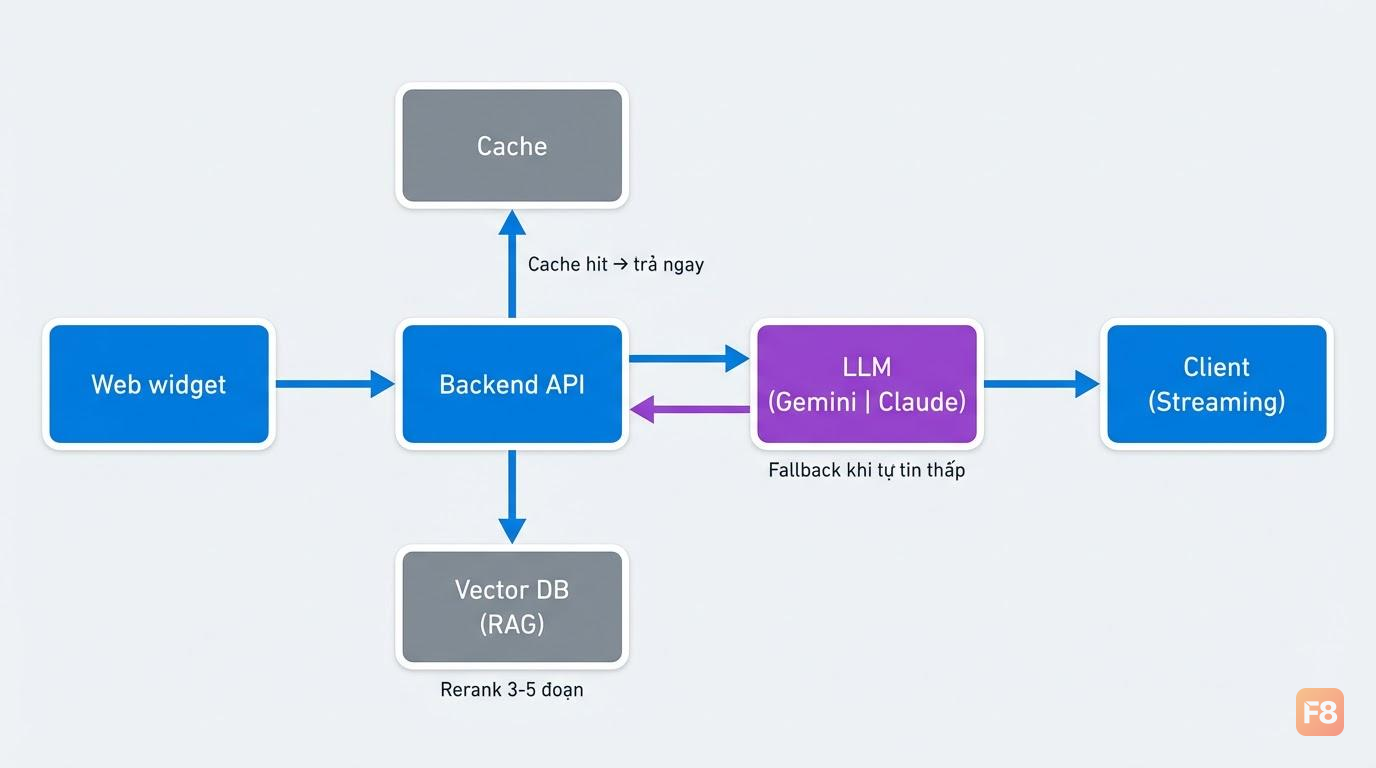 Giảm chi phí thật nằm ở cache và rerank trước khi gọi LLM
Case phổ biến: chỉ cần cache tốt đã đạt tỉ lệ hit khoảng một mức đáng kể ở các site có FAQ lặp lại. Với site hỏi lặp lại, con số này cứu ví tiền đáng kể.
Code mẫu: Next.js API route gọi Gemini và Claude
Mục tiêu: 1 endpoint, chọn provider theo tham số, có streaming, giới hạn token, và log chi phí. Bạn có thể cắm ngay vào form chat trên web hiện tại.
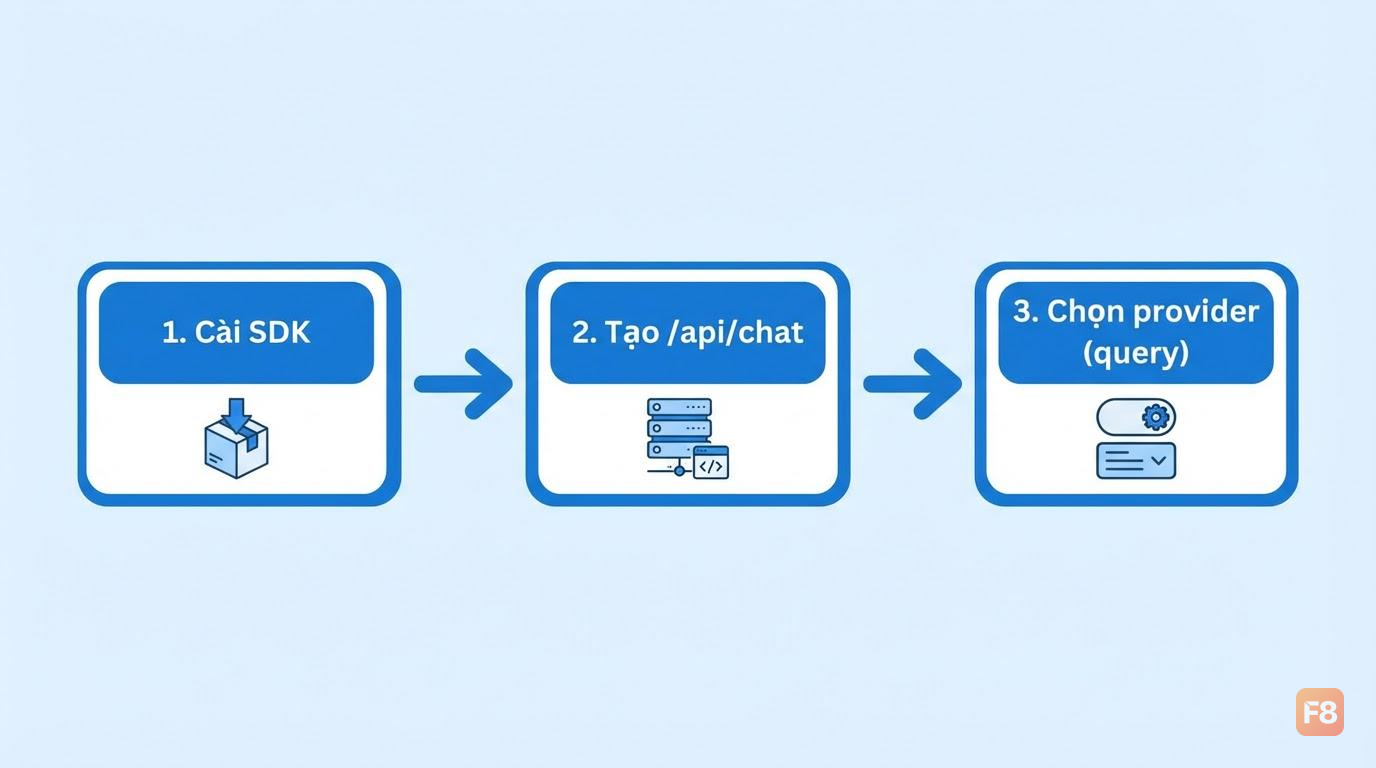 Một route, đổi provider bằng tham số, dễ A/B test
Gợi ý nâng cấp: trả về SSE để stream token, thêm JSON schema cho câu trả lời dạng cấu trúc, và log usage theo provider để tối ưu prompt ở tuần sau.
Case study: shop nội thất, traffic thấp nhưng hỏi dồn giờ cao điểm
Bối cảnh: shop nội thất nhận câu hỏi lặp lại về kích thước, phí vận chuyển, tình trạng kho. Mình triển khai cache theo intent, RAG từ catalog, và fallback Claude khi Gemini báo tự tin thấp với đơn hàng phức tạp.
Kết quả sau 4 tuần: chi phí trung bình mỗi hội thoại giảm xuống 50% (HelloTars Sierra AI Alternatives), tỉ lệ tự động hóa đạt 70-80% of routine customer inquiries handled by AI chatbots (Connect Media Agency - 15 E-Commerce Technology Trends for 2026), thời gian phản hồi đầu tiên còn Reduced average wait time from 8 minutes to under 30 seconds (Verizon case study, 12 months through September 2024) (Artic Sledge AI Virtual Assistant for Business). Impact? Nhân sự chăm sóc chuyển sang xử lý lead nóng và upsell.
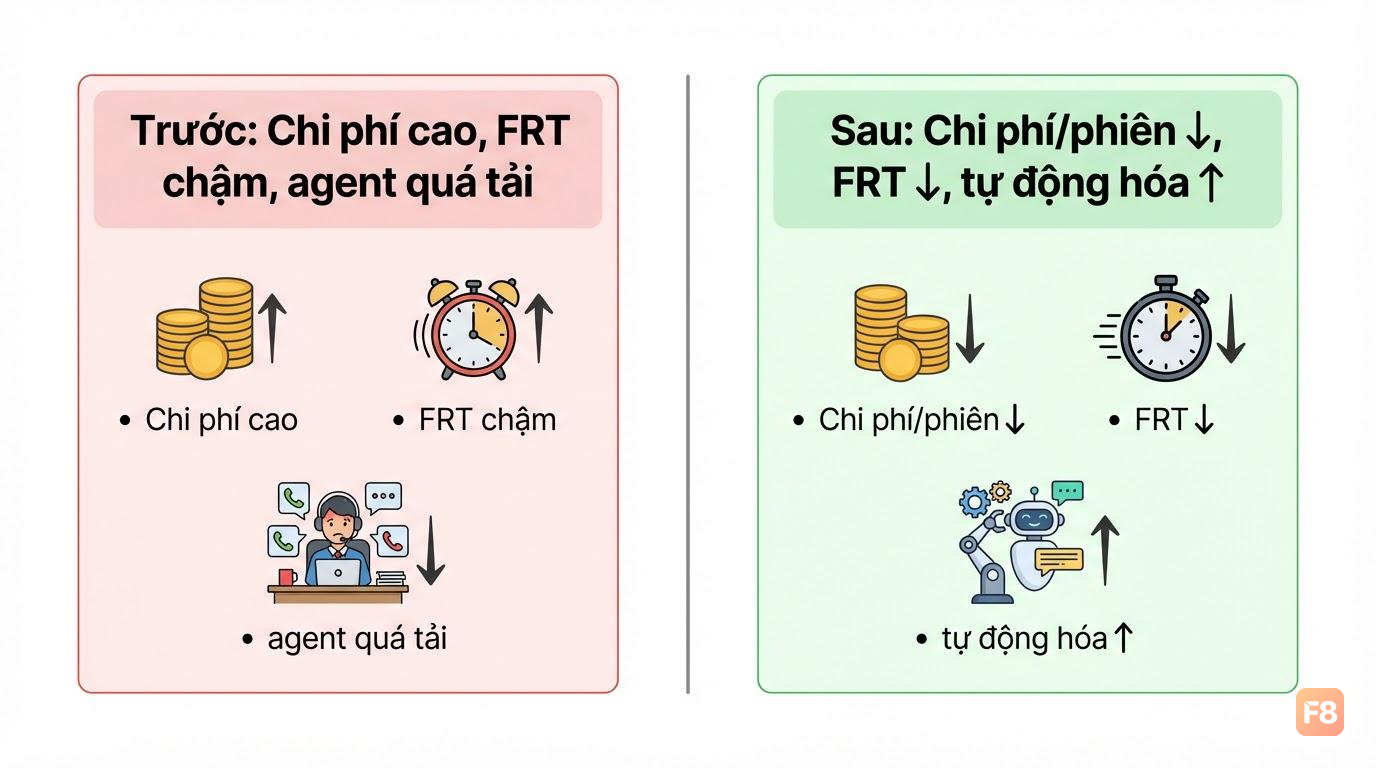 Tập trung giờ cao điểm, cache cứu chi phí nhiều nhất
Trade-off: cập nhật tồn kho thay đổi liên tục dễ làm RAG lỗi thời. Remedy: đồng bộ vector mỗi 30 phút và cho phép agent override câu trả lời bằng macro chuẩn.
Checklist 7 ngày: đưa chatbot lên web và đo lường
Bạn muốn đi nhanh, ít rủi ro. Làm lần lượt, đo mỗi bước rồi mới mở throttle.
- Ngày 1: gom FAQ, chính sách, macro trả lời. Sinh vector từ nguồn đã kiểm duyệt.
- Ngày 2: dựng backend API, bật streaming và log tokens.
- Ngày 3: cắm web widget, A/B Gemini vs Claude trên 20% traffic.
- Ngày 4: thêm cache intent và rerank 3-5 đoạn.
- Ngày 5: đo cost/phút và FRT, siết max tokens, temperature 0.2-0.4.
- Ngày 6: fallback khi tự tin thấp, thêm JSON mode cho trả lời có cấu trúc.
- Ngày 7: review log, chốt model mặc định theo cost kèm SLA.
Tải checklist điền sẵn: Tải checklist 7 ngày
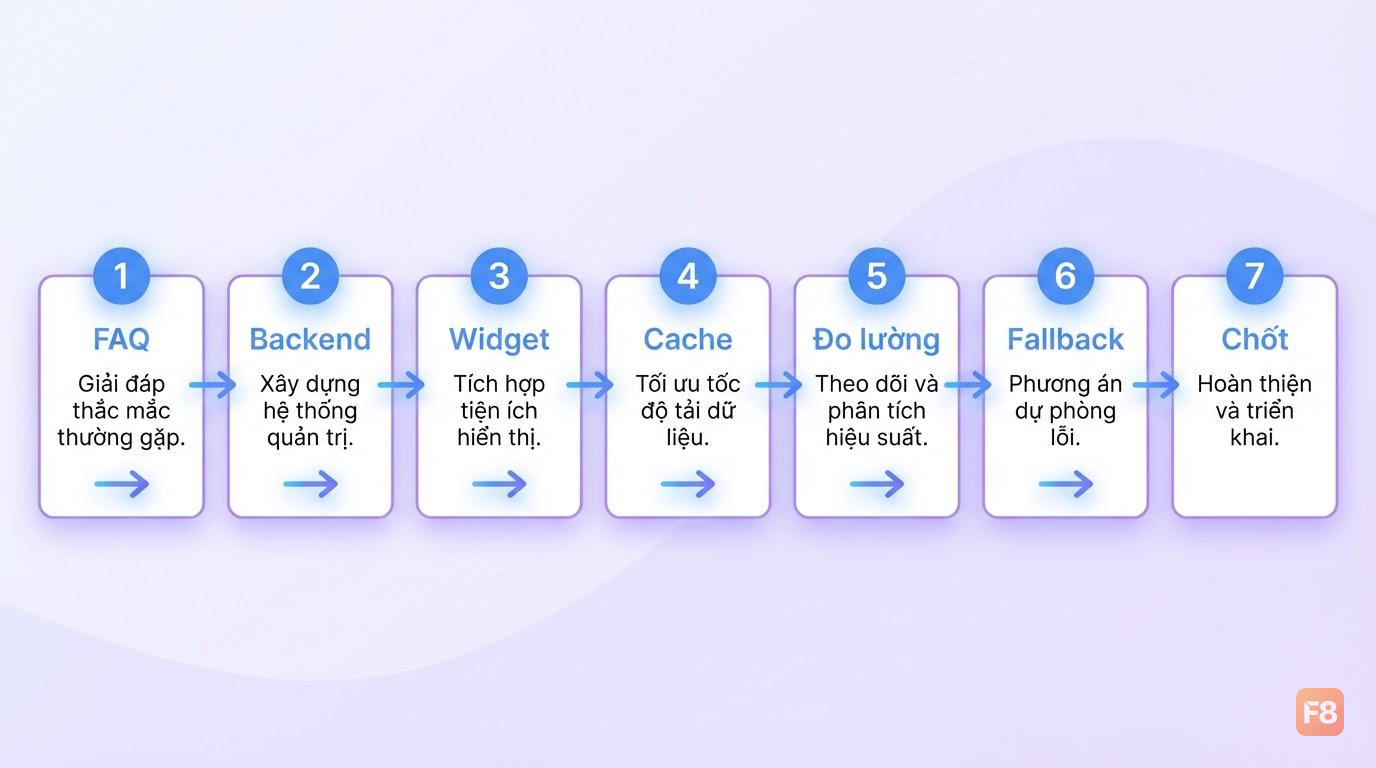 Làm từng ngày, mỗi ngày một mục tiêu rõ ràng
Đừng quên giới hạn usage theo IP và domain, tránh abuse làm đội chi phí.