Gọi API AI từ website: đặt khóa ở server và giới hạn request theo người dùng
6 giờ tới · 10 phút đọc
Tại sao không đặt API key AI trực tiếp trong code frontend?
Nếu bạn viết const apiKey = 'sk-...' trong file JavaScript của React hay Vue rồi gọi thẳng tới OpenAI hoặc Google Gemini từ trình duyệt, khóa đó sẽ bị lộ. Bất kỳ ai mở DevTools, xem tab Network, hoặc đọc source bundle đều thấy được.
Vấn đề không chỉ là lộ khóa. Khi khóa bị lấy, người khác dùng quota của bạn, phát sinh chi phí không kiểm soát được, và bạn không biết ai đang gọi API với danh nghĩa ứng dụng của mình.
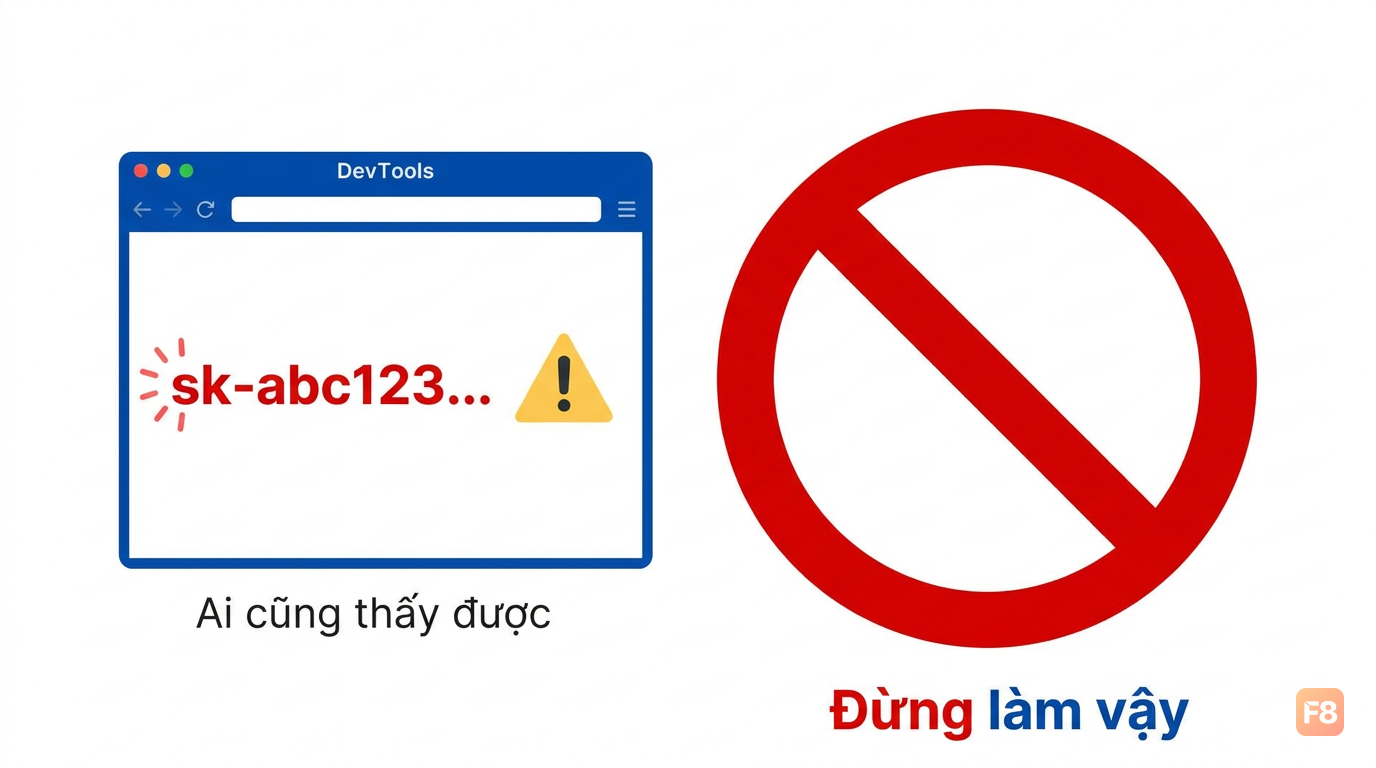 Khóa để trong bundle JS - ai cũng xem được qua DevTools
Giải pháp chuẩn: không bao giờ để secret key ở frontend. Thay vào đó, frontend gọi tới server của bạn, server giữ khóa và gọi tiếp tới AI provider. Luồng đi là: Browser → Server của bạn → AI Provider.
Cách này tạo ra một lớp kiểm soát ở giữa - bạn quyết định ai được gọi, gọi bao nhiêu lần, và xử lý lỗi trước khi trả về client.
Lưu ý: Kiến trúc proxy server giảm rủi ro đáng kể, nhưng không có cơ chế bảo mật nào là tuyệt đối. Bạn vẫn cần bảo vệ server, rotate key định kỳ và monitor usage.
Sơ đồ kiến trúc: Browser - Server - AI Provider
Dưới đây là luồng hoạt động đầy đủ khi bạn dùng proxy server để gọi API AI một cách an toàn:
Browser (React/Vue/JS thuần)
  │
  │  POST /api/chat  { message: "..." }  [không có API key]
  ▼
Server của bạn (Node/Express hoặc tương đương)
  │  Kiểm tra: user đã đăng nhập chưa?
  │  Kiểm tra: user còn quota không?
  │  Gắn API_KEY từ biến môi trường
  │
  │  POST https://api.openai.com/v1/chat/completions
  │      Authorization: Bearer <API_KEY_LƯU_TRÊN_SERVER>
  ▼
AI Provider (OpenAI / Gemini / Claude...)
  │
  │  Trả về kết quả
  ▼
Server của bạn
  │  Ghi log, trừ quota
  ▼
Browser nhận kết quả
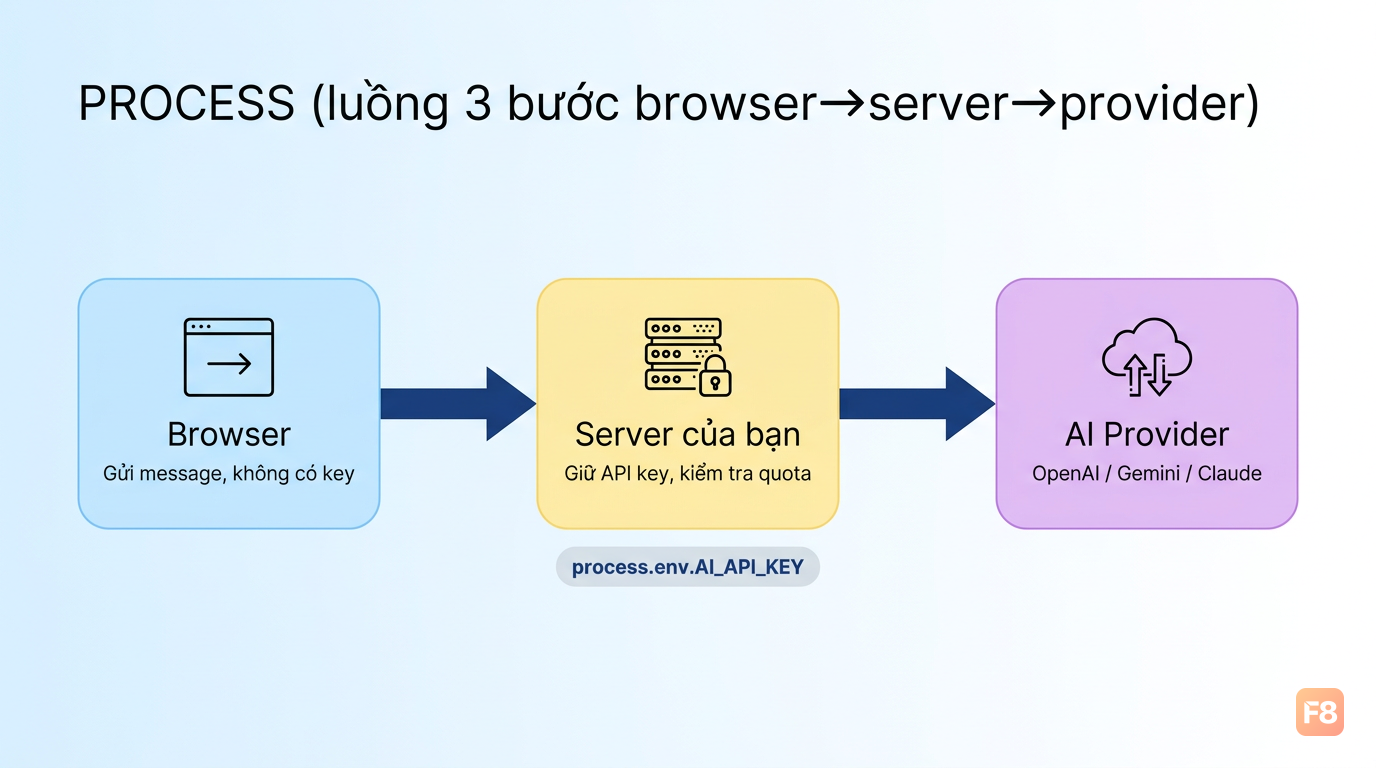 Luồng một chiều: browser không bao giờ chạm trực tiếp tới AI provider
Ba vai trò trong sơ đồ này:
- Browser: chỉ gửi nội dung cần hỏi, không biết API key tồn tại ở đâu
- Server của bạn: giữ key trong biến môi trường (
process.env.AI_API_KEY), xác thực người dùng, kiểm tra quota, rồi mới gọi provider - AI Provider: chỉ nhận request từ server, không tiếp xúc trực tiếp với browser người dùng
Một điểm hay của kiến trúc này: bạn có thể đổi provider (từ OpenAI sang Gemini chẳng hạn) mà frontend không cần thay đổi gì. Toàn bộ logic nằm ở server.
Cài đặt proxy đơn giản với Node.js và Express
Phần này dùng Node.js + Express làm ví dụ minh họa (dạng bài tập, chưa phải production). Nếu bạn dùng framework khác (Next.js API Routes, Fastify, Python Flask...) logic tương tự, chỉ khác cú pháp.
Bước 1: Lưu API key vào biến môi trường
Tạo file .env ở thư mục gốc server (không commit file này lên Git):
AI_API_KEY=YOUR_ACTUAL_KEY_HERE
AI_BASE_URL=https://api.openai.com/v1
Thêm .env vào .gitignore ngay:
# .gitignore
.env
.env.local
Bước 2: Tạo route proxy trên server
Ví dụ minh họa (placeholder - cần điều chỉnh theo provider thực tế bạn dùng):
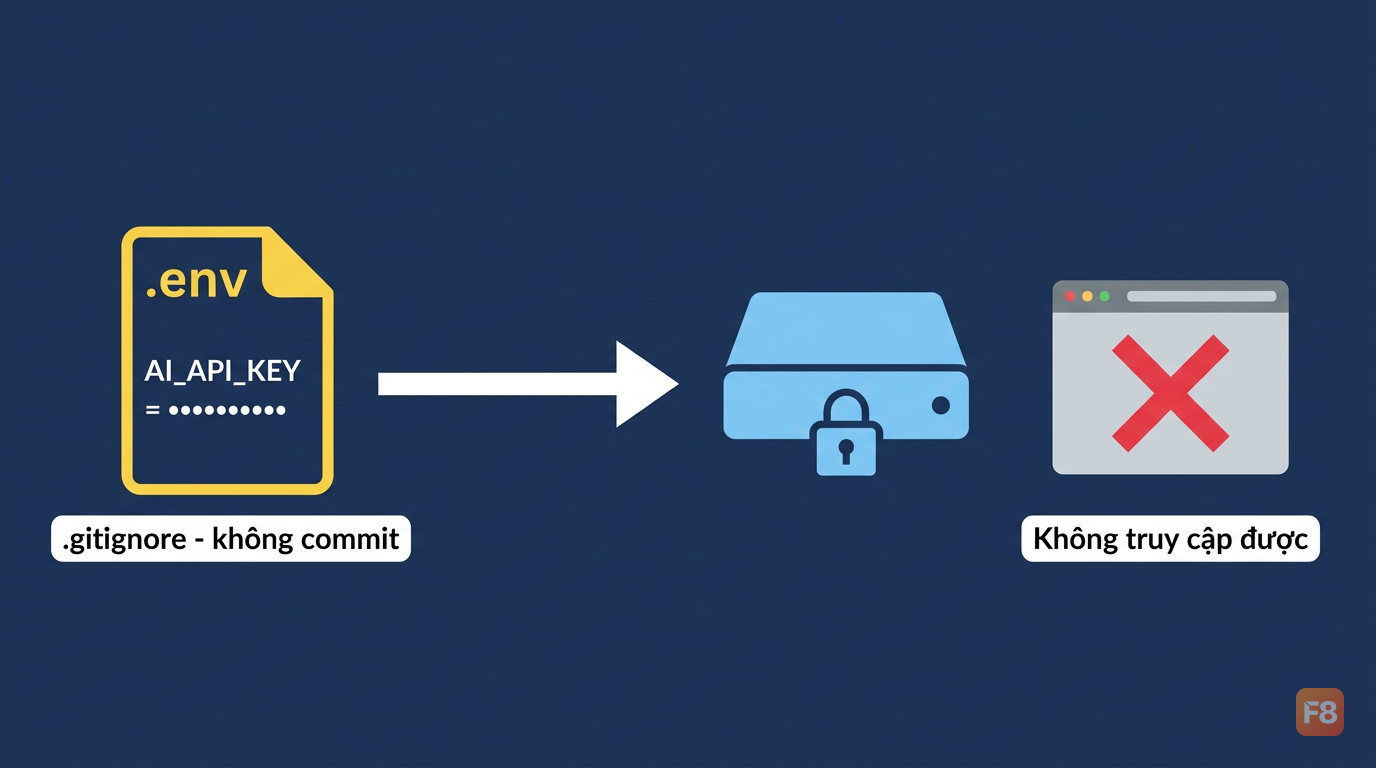 Biến môi trường - chỉ server thấy, không bao giờ ra ngoài
Cách kiểm tra thủ công:
Kết quả mong đợi: { "reply": "Xin chào! Tôi có thể giúp gì cho bạn?" } (nội dung tùy model).
Nếu thiếu Authorization header, server trả 401. Nếu AI provider lỗi, server trả 502 và log chi tiết nội bộ - không lộ thông tin nhạy cảm ra ngoài.
Middleware xác thực: ai được phép gọi API?
Proxy server chặn được người ngoài đọc key, nhưng nếu route /api/chat không có xác thực thì bất kỳ ai cũng gọi được - kể cả script tự động.
Bạn cần middleware kiểm tra danh tính người dùng trước khi cho phép gọi AI. Ví dụ minh họa dùng JWT (JSON Web Token - một chuẩn phổ biến để truyền thông tin xác thực giữa client và server):
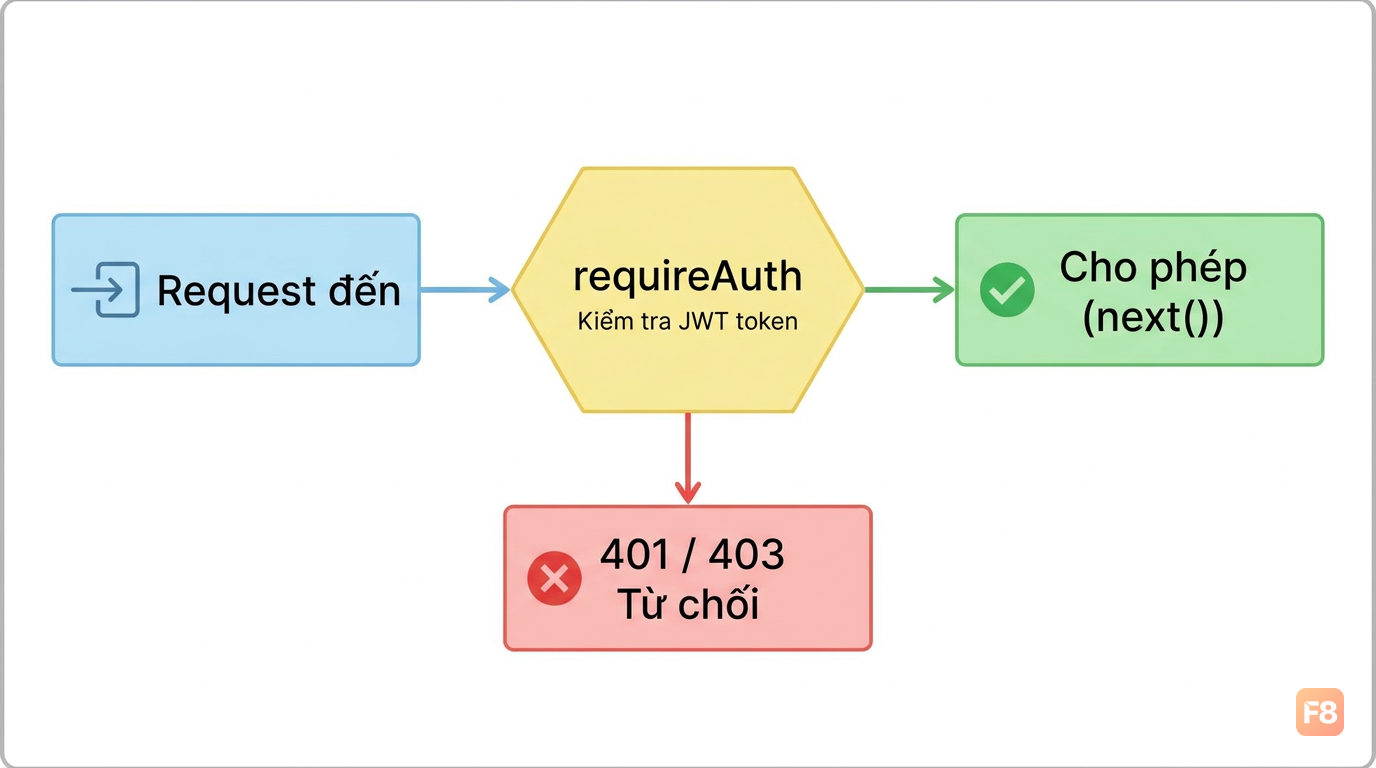 Middleware như người gác cổng - kiểm tra token trước khi cho vào
Sau khi có req.user, route /api/chat biết request đến từ user nào - cần thiết để bước tiếp theo: giới hạn quota.
Lỗi thường gặp ở bước này:
- Quên thêm
requireAuthvào route → route mở hoàn toàn - So sánh token bằng
==thay vìjwt.verify()→ dễ giả mạo - Không đặt
JWT_SECRETvào biến môi trường mà hard-code trong code → tương tự lộ API key - CORS chưa cấu hình đúng → browser chặn request trước khi tới middleware
Giới hạn request theo người dùng (rate limiting và quota)
Xác thực giải quyết câu hỏi "ai được gọi?". Nhưng còn câu hỏi "gọi bao nhiêu lần?" - đây là phần quan trọng không kém, đặc biệt vì các AI provider tính phí theo token dùng.
Hai loại giới hạn bạn cần:
- Rate limit: giới hạn số request trong một khoảng thời gian ngắn (ví dụ: tối đa 10 request/phút/user)
- Quota: giới hạn tổng tài nguyên trong khoảng dài hơn (ví dụ: 100 request/ngày hoặc 50.000 token/tháng)
Cách đơn giản dùng express-rate-limit:
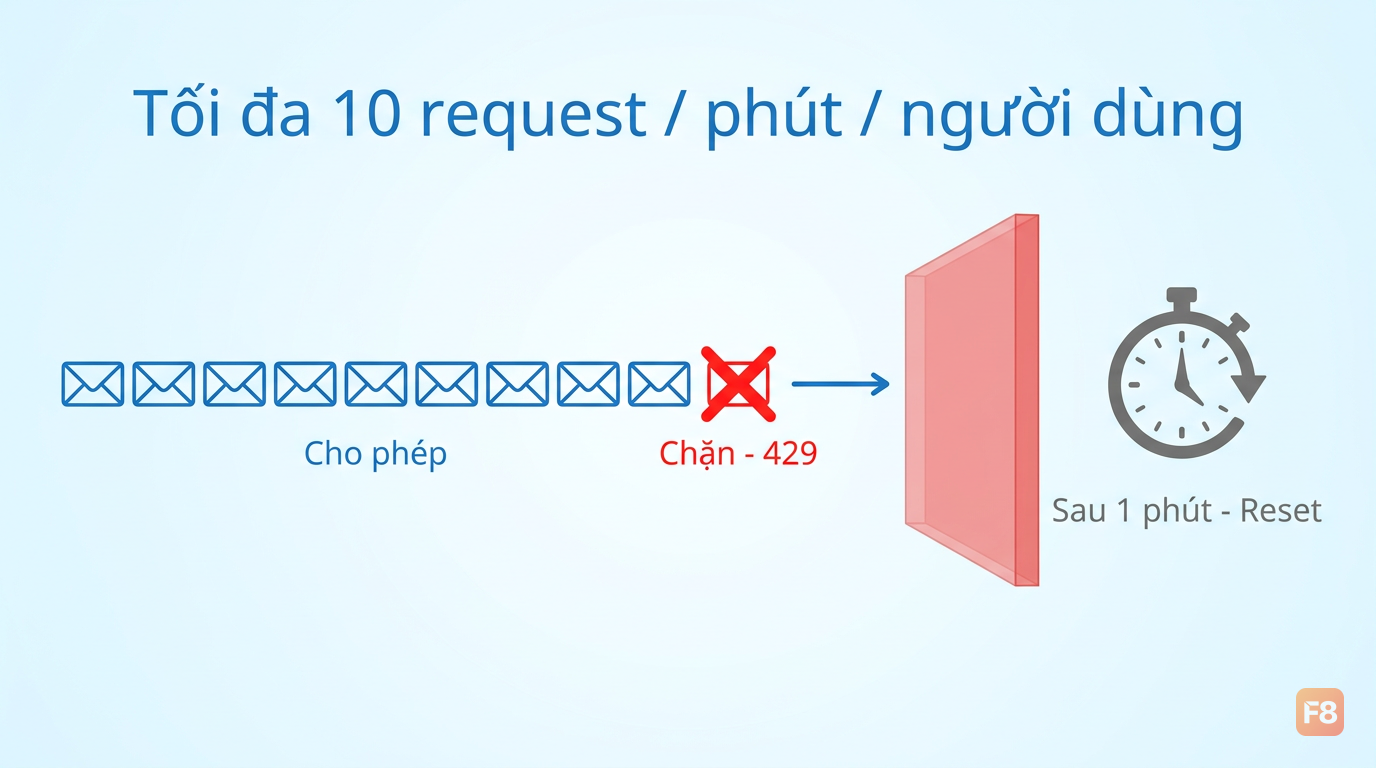 Rate limit: 10 request đầu đi qua, request thứ 11 bị chặn ngay lập tức
Quota dài hạn - cần lưu vào database:
Rate limit trong bộ nhớ sẽ reset khi server khởi động lại. Để theo dõi quota theo ngày/tháng, bạn cần ghi vào database (ví dụ: MongoDB, PostgreSQL):
Trả thêm header X-RateLimit-Remaining trong response để frontend biết còn bao nhiêu lượt:
Giới hạn nên đặt ở mức nào? Phụ thuộc vào chi phí provider và kế hoạch của bạn. Chưa có số chuẩn - hãy theo dõi usage thực tế vài tuần đầu rồi điều chỉnh.
Lỗi thường gặp và cách xử lý
Dưới đây là các tình huống hay gặp khi triển khai proxy AI, kèm cách xử lý cụ thể:
1. CORS block - browser từ chối request
Triệu chứng: lỗi Access-Control-Allow-Origin trong console trình duyệt.
2. API key hết hạn hoặc hết credit
Triệu chứng: provider trả về 401 hoặc 402. Server nên log chi tiết nội bộ và chỉ trả về thông báo chung cho client:
3. Request quá lớn (token overflow)
Giới hạn độ dài input trước khi gửi đi:
4. Timeout khi model phản hồi chậm
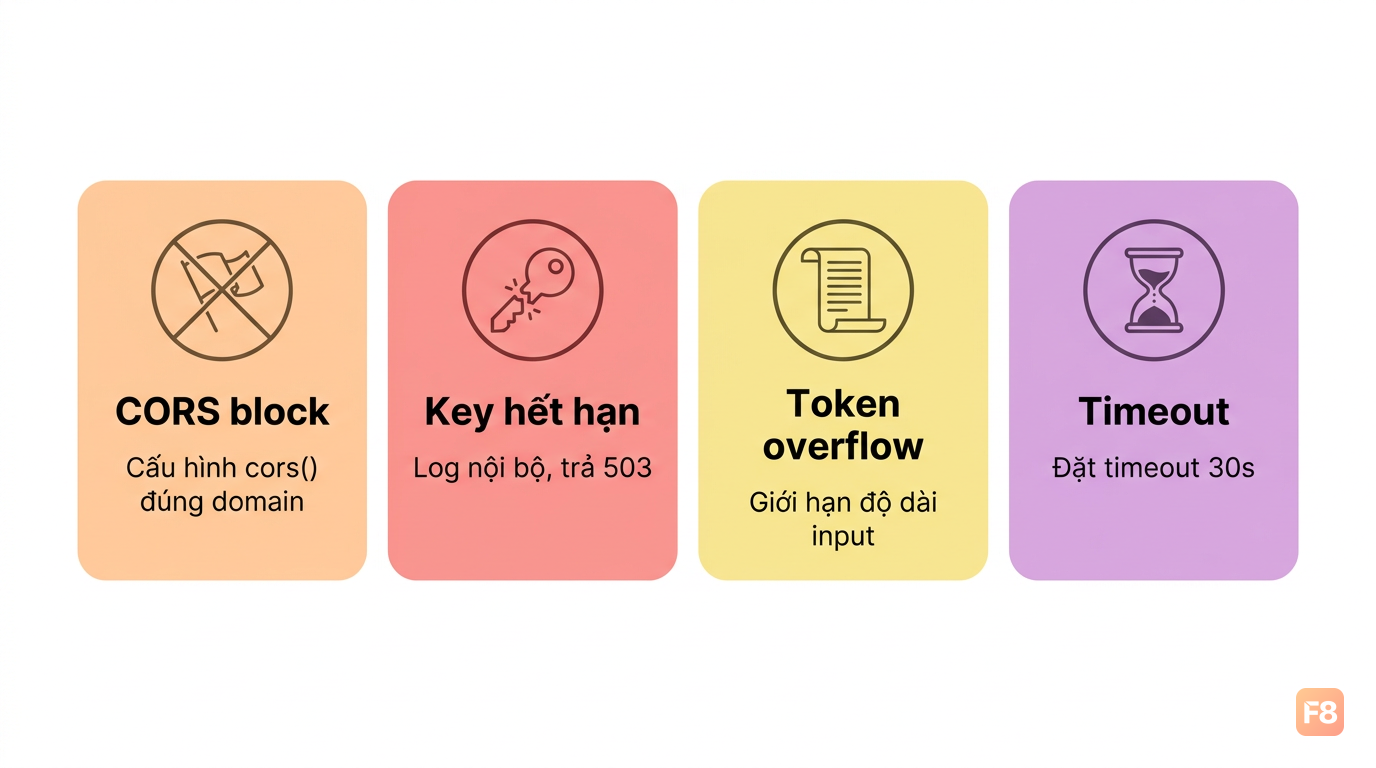 Bốn lỗi phổ biến - mỗi cái có cách xử lý riêng
5. Lộ thông tin lỗi nhạy cảm
Không trả nguyên err.response.data về client vì có thể chứa thông tin provider, billing, hoặc cấu hình nội bộ. Log đầy đủ ở server, trả về thông báo chung ở client.