Đang tải...

Ếch Trendy

Cùng chú ếch nhỏ khám phá thế giới Web đầy biến động. Cập nhật trending nhanh như cách ếch đớp mồi! ⌨️🌿


0

Tích hợp OpenAI, Claude API, Gemini API vào web app: Hướng dẫn thực chiến 2026
Ếch Trendy
Ếch Trendy

một tháng trước · 10 phút đọc

Chọn sai API mất cả tháng refactor

Mình từng build chatbot cho một dự án e-commerce, chọn đại một API vì thấy benchmark trên mạng đẹp. Ba tuần sau mới phát hiện rate limit của tier free không đủ dùng khi traffic tăng, phải refactor toàn bộ layer gọi API. Mất thêm một tuần. Đáng lẽ 30 phút research ban đầu có thể tránh được chuyện đó.

Năm 2026, có ba ông lớn mà hầu hết dự án web đều cân nhắc: OpenAI (GPT-4 và các biến thể), Anthropic Claude (3.5 Sonnet, 3.7...) và Google Gemini (2.0 Flash, Pro). Mỗi cái mạnh ở góc khác nhau, và chọn đúng từ đầu tiết kiệm rất nhiều đau khổ về sau.

Bài này mình đi từ so sánh thực tế đến code mẫu chạy được, cover streaming, error handling, cost optimization và security. Đủ để bạn chọn API và triển khai trong một ngày.


So sánh thực chiến: chi phí, tốc độ, chất lượng

Benchmark tổng quát trên internet thường không phản ánh workload thật của bạn. Nhưng để có điểm xuất phát, đây là những gì mình quan sát qua thực tế dự án:
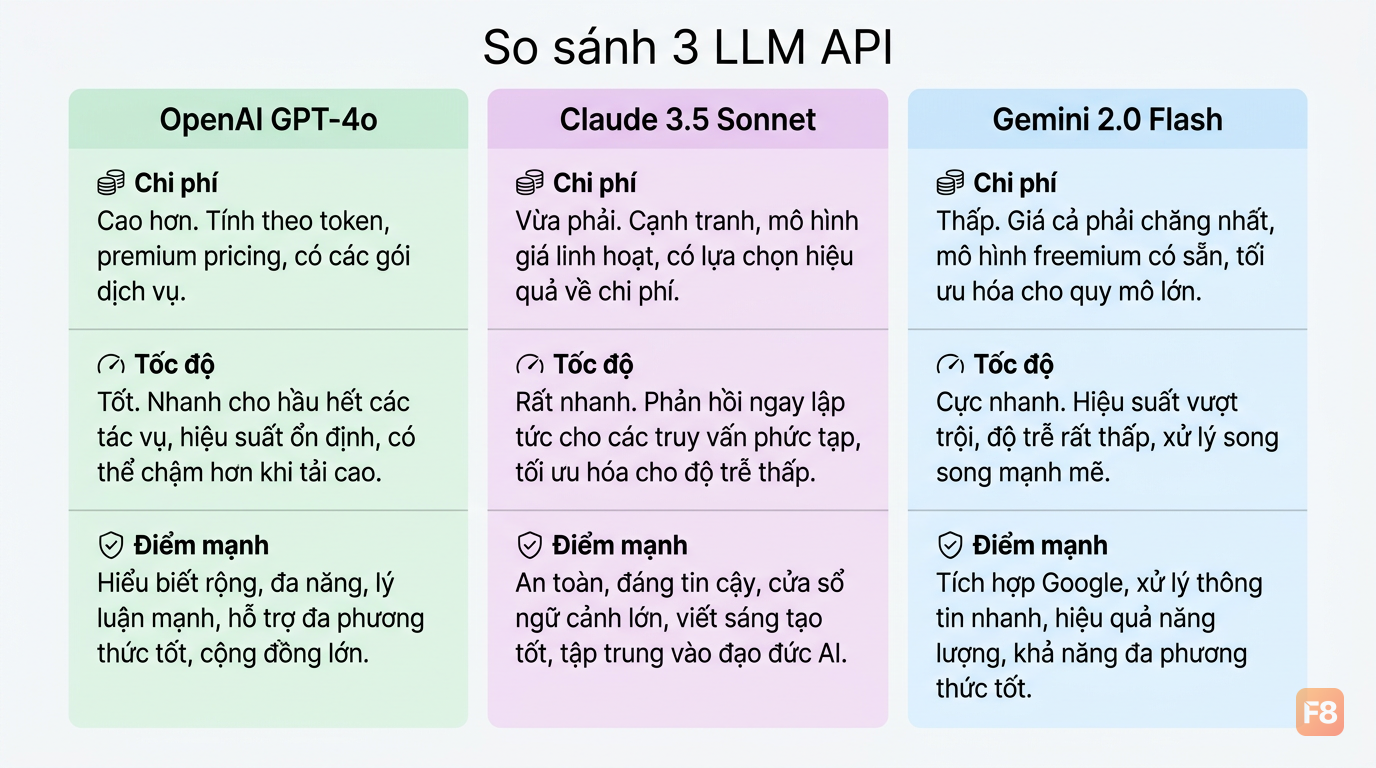
346881 Mỗi API có điểm mạnh riêng - chọn theo use case, không theo hype

Chi phí token

Cả ba đều tính theo input/output tokens. Điểm cần nhớ: output tokens thường đắt hơn input (thường gấp 3-5 lần). Với tác vụ sinh nội dung dài như viết bài hoặc phân tích code, output cost là phần chiếm phần lớn hóa đơn.

Gemini 2.0 Flash hiện là lựa chọn rẻ nhất trong ba nếu volume cao. Claude 3.5 Sonnet và OpenAI GPT-4o ở mức giá tương đương nhau, nhưng cần kiểm tra trang pricing chính thức vì giá thay đổi theo model và tier - số liệu trên blog bên thứ ba thường lỗi thời sau vài tuần.

Tốc độ response

Với web app, streaming quan trọng hơn raw latency. Người dùng không quan tâm response mất 3 giây hay 5 giây nếu chữ hiện ra dần dần từ giây đầu tiên. Gemini 2.0 Flash nổi tiếng nhanh cho text ngắn. GPT-4o Turbo ổn định. Claude 3.5 Sonnet đôi khi chậm hơn nhưng bù lại chất lượng output thường tốt hơn cho văn bản dài.

Một điều nên làm: benchmark trên chính workload của bạn. Gửi 50 request sample từ production data thật, đo TTFT (Time to First Token) và total latency. Hai con số này quan trọng hơn bất kỳ benchmark tổng quát nào.

Chất lượng output theo use case

  • Chatbot hỗ trợ khách hàng: OpenAI mạnh về tool calling và workflow phức tạp; Claude tốt hơn khi cần giọng điệu tự nhiên và hội thoại dài.
  • Content generation: Claude thường ra văn bản tự nhiên hơn, ít "AI-sounding" hơn. OpenAI mạnh khi cần kết hợp sinh nội dung với các tool khác.
  • Code analysis: cả OpenAI và Claude đều tốt; Claude được nhiều dev ưa hơn cho code review dài vì giải thích chi tiết.
  • AI search / RAG: cả ba đều làm được; Gemini có lợi thế nếu bạn dùng Google ecosystem (Drive, Docs, Search).
  • Task automation: OpenAI nổi bật về function calling/tool orchestration.

Kiến trúc đúng: không bao giờ gọi API trực tiếp từ frontend

Lỗi phổ biến nhất mình thấy trong các project mới: gọi OpenAI/Claude/Gemini API thẳng từ React component. API key lộ ngay trong Network tab của browser DevTools. Bất kỳ ai mở F12 đều lấy được key và dùng thoải mái theo quota của bạn.
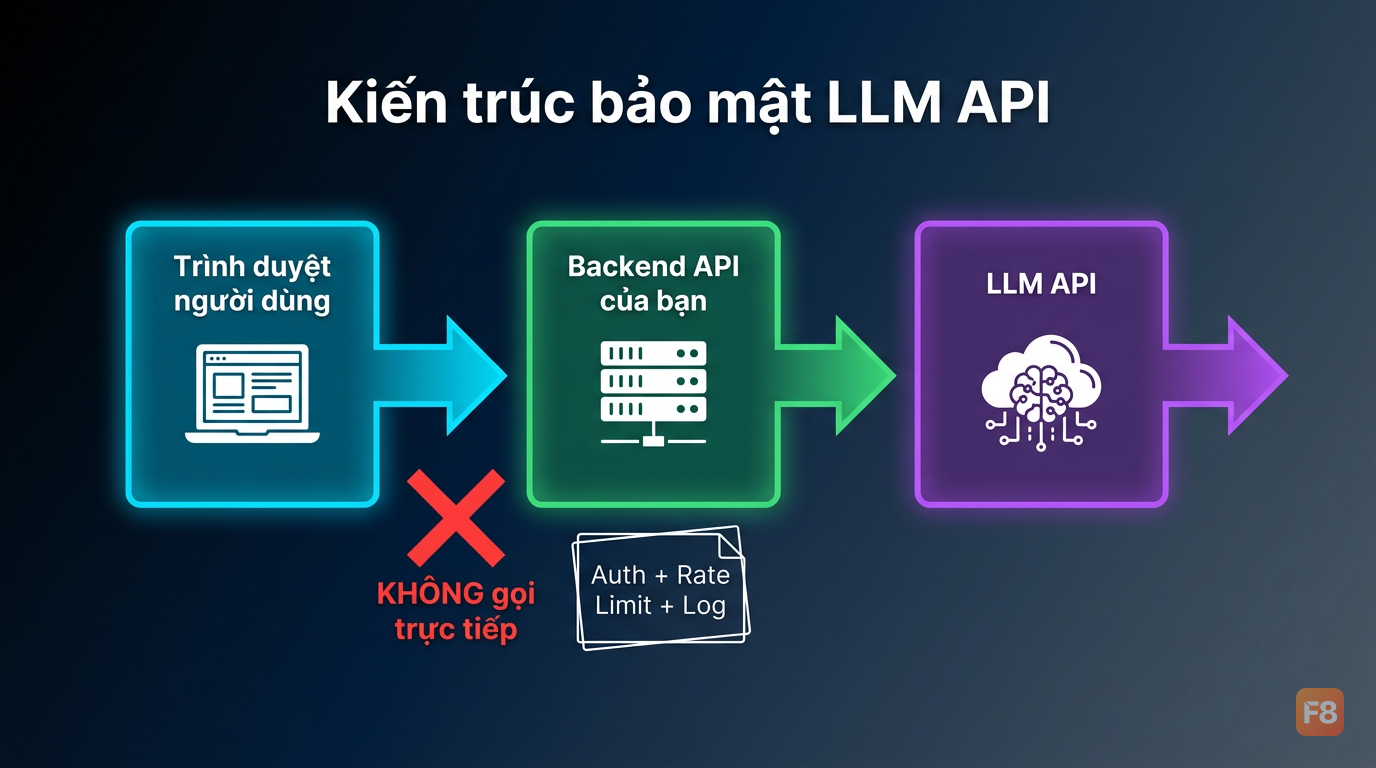
346882 Frontend chỉ nói chuyện với backend của bạn - không bao giờ gọi LLM API trực tiếp

Kiến trúc chuẩn:

User Browser → Your Backend API → LLM API

Backend của bạn đảm nhiệm:

  • Xác thực user (JWT, session)
  • Rate limiting theo user/org (tránh một user abuse)
  • Gọi LLM API với API key được giữ an toàn trong env vars
  • Stream response về client
  • Logging, audit trail
  • Fallback khi LLM API lỗi

Với Node.js/Express, flow cơ bản trông như thế này:

// Route xử lý chat - không bao giờ expose API key ra client
app.post('/api/chat', authenticate, rateLimiter, async (req, res) => {
  const { messages, userId } = req.body;

  // Validate input trước khi gửi lên LLM
  if (!messages || !Array.isArray(messages)) {
    return res.status(400).json({ error: 'Invalid messages format' });
  }

  // Set header cho SSE streaming
  res.setHeader('Content-Type', 'text/event-stream');
  res.setHeader('Cache-Control', 'no-cache');
  res.setHeader('Connection', 'keep-alive');

  try {
    await streamFromLLM(messages, res);
  } catch (err) {
    // Log lỗi server-side, không trả stack trace về client
    console.error('[LLM Error]', err.message);
    res.write(`data: ${JSON.stringify({ error: 'Service unavailable' })}\n\n`);
    res.end();
  }
});

Nếu bạn đang xây backend Node.js từ đầu, khóa Node & ExpressJS của F8 cover các phần như routing, middleware và RESTful API - những thứ bạn cần để build layer này đúng cách.


Streaming responses: cách làm đúng

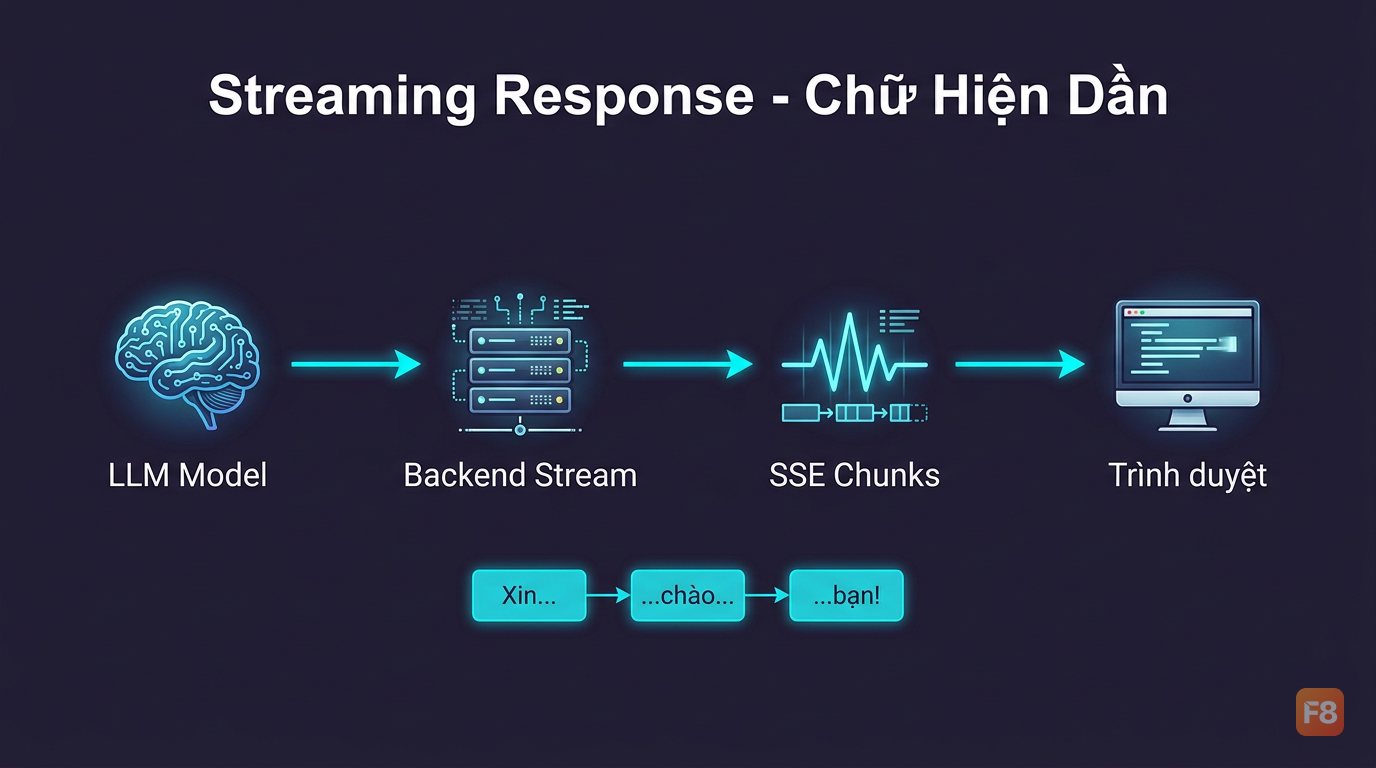
Streaming là thứ phân biệt chatbot cảm giác "nhanh" và chatbot cảm giác "đứng hình". Thay vì đợi model sinh xong toàn bộ response mới trả về, bạn forward từng chunk ngay khi nhận được.

Dưới đây là cách implement streaming với cả ba platform. Cú pháp khác nhau nhưng pattern giống nhau.

OpenAI streaming

import OpenAI from 'openai';

const openai = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY, // Lấy từ env, không hardcode
});

async function streamOpenAI(messages, res) {
  // Tạo stream với stream: true
  const stream = await openai.chat.completions.create({
    model: 'gpt-4o',
    messages,
    stream: true,
    max_tokens: 1000,
  });

  for await (const chunk of stream) {
    const content = chunk.choices[0]?.delta?.content || '';
    if (content) {
      // Forward chunk về client theo format SSE
      res.write(`data: ${JSON.stringify({ content })}\n\n`);
    }
  }

  // Báo client đã xong
  res.write('data: [DONE]\n\n');
  res.end();
}

Claude (Anthropic) streaming

import Anthropic from '@anthropic-ai/sdk';

const anthropic = new Anthropic({
  apiKey: process.env.ANTHROPIC_API_KEY,
});

async function streamClaude(messages, res) {
  const stream = anthropic.messages.stream({
    model: 'claude-3-5-sonnet-20241022',
    max_tokens: 1024,
    // System prompt tách riêng khỏi messages trong Claude API
    system: 'Bạn là trợ lý hỗ trợ khách hàng thân thiện.',
    messages,
  });

  // Claude dùng event-based stream
  stream.on('text', (text) => {
    res.write(`data: ${JSON.stringify({ content: text })}\n\n`);
  });

  await stream.finalMessage();
  res.write('data: [DONE]\n\n');
  res.end();
}

Gemini streaming

import { GoogleGenerativeAI } from '@google/generative-ai';

const genAI = new GoogleGenerativeAI(process.env.GEMINI_API_KEY);

async function streamGemini(userMessage, res) {
  const model = genAI.getGenerativeModel({ model: 'gemini-2.0-flash' });

  // Gemini dùng generateContentStream cho streaming
  const result = await model.generateContentStream(userMessage);

  for await (const chunk of result.stream) {
    const text = chunk.text();
    if (text) {
      res.write(`data: ${JSON.stringify({ content: text })}\n\n`);
    }
  }

  res.write('data: [DONE]\n\n');
  res.end();
}

346883 Cả ba SDK đều hỗ trợ streaming - pattern SSE giống nhau, chỉ khác cú pháp

Frontend nhận stream

// React component đọc SSE stream từ backend
async function sendMessage(userInput) {
  setIsStreaming(true);
  setResponse('');

  const response = await fetch('/api/chat', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ messages: [{ role: 'user', content: userInput }] }),
  });

  const reader = response.body.getReader();
  const decoder = new TextDecoder();

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    const lines = decoder.decode(value).split('\n');
    for (const line of lines) {
      if (line.startsWith('data: ') && line !== 'data: [DONE]') {
        const data = JSON.parse(line.slice(6));
        // Append từng chunk vào state
        setResponse(prev => prev + (data.content || ''));
      }
    }
  }

  setIsStreaming(false);
}

Error handling và rate limit: đừng để app crash vì LLM

LLM API fail không phải là "nếu" mà là "khi nào". Rate limit hit, timeout, model overload - tất cả đều xảy ra. App của bạn phải handle gracefully thay vì crash hoặc trả lỗi 500 về người dùng.
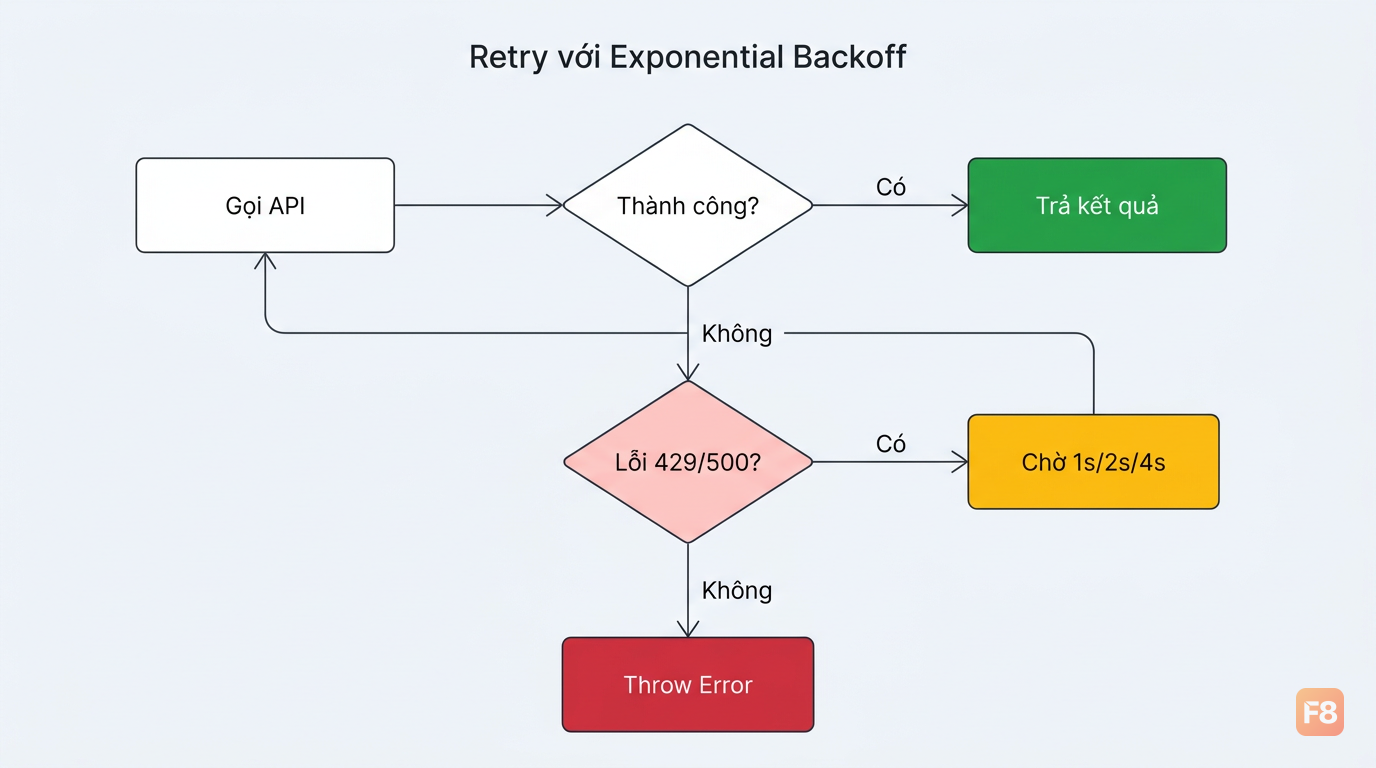
346884 Retry với exponential backoff ngăn app spam API khi gặp lỗi tạm thời

Exponential backoff retry

// Retry với backoff - tránh hammer API khi bị rate limit
async function callWithRetry(apiCall, maxRetries = 3) {
  for (let attempt = 0; attempt < maxRetries; attempt++) {
    try {
      return await apiCall();
    } catch (err) {
      const isRateLimit = err.status === 429;
      const isServerError = err.status >= 500;
      const shouldRetry = isRateLimit || isServerError;

      if (!shouldRetry || attempt === maxRetries - 1) {
        throw err; // Không retry nữa, throw lên trên handle
      }

      // Exponential backoff: 1s, 2s, 4s...
      const waitTime = Math.pow(2, attempt) * 1000;
      console.log(`[Retry] Attempt ${attempt + 1} failed, waiting ${waitTime}ms`);
      await new Promise(resolve => setTimeout(resolve, waitTime));
    }
  }
}

Multi-provider fallback

Nếu app cần uptime cao, pattern fallback giữa các provider là thứ đáng làm:

// Thử primary provider trước, fallback sang secondary nếu fail
async function callWithFallback(messages) {
  const providers = [
    () => callOpenAI(messages),
    () => callClaude(messages),
    () => callGemini(messages),
  ];

  for (const provider of providers) {
    try {
      return await provider();
    } catch (err) {
      // Log lỗi nhưng thử provider tiếp theo
      console.error('[Provider failed]', err.message);
      continue;
    }
  }

  // Tất cả provider đều fail
  throw new Error('All LLM providers unavailable');
}

Rate limit theo Claude API

Claude đặc biệt ở chỗ giới hạn theo ba chiều: Requests/phút (RPM), Input tokens/phút (ITPM) và Output tokens/phút (OTPM). App của bạn có thể bị block không phải vì gửi quá nhiều request mà vì một vài request có output quá dài làm cạn OTPM.

Xử lý: theo dõi response headers anthropic-ratelimit-* để biết còn quota bao nhiêu, và cân nhắc đặt max_tokens thấp hơn mặc định nếu use case không cần output dài.


Cost optimization: giảm hóa đơn mà không giảm chất lượng

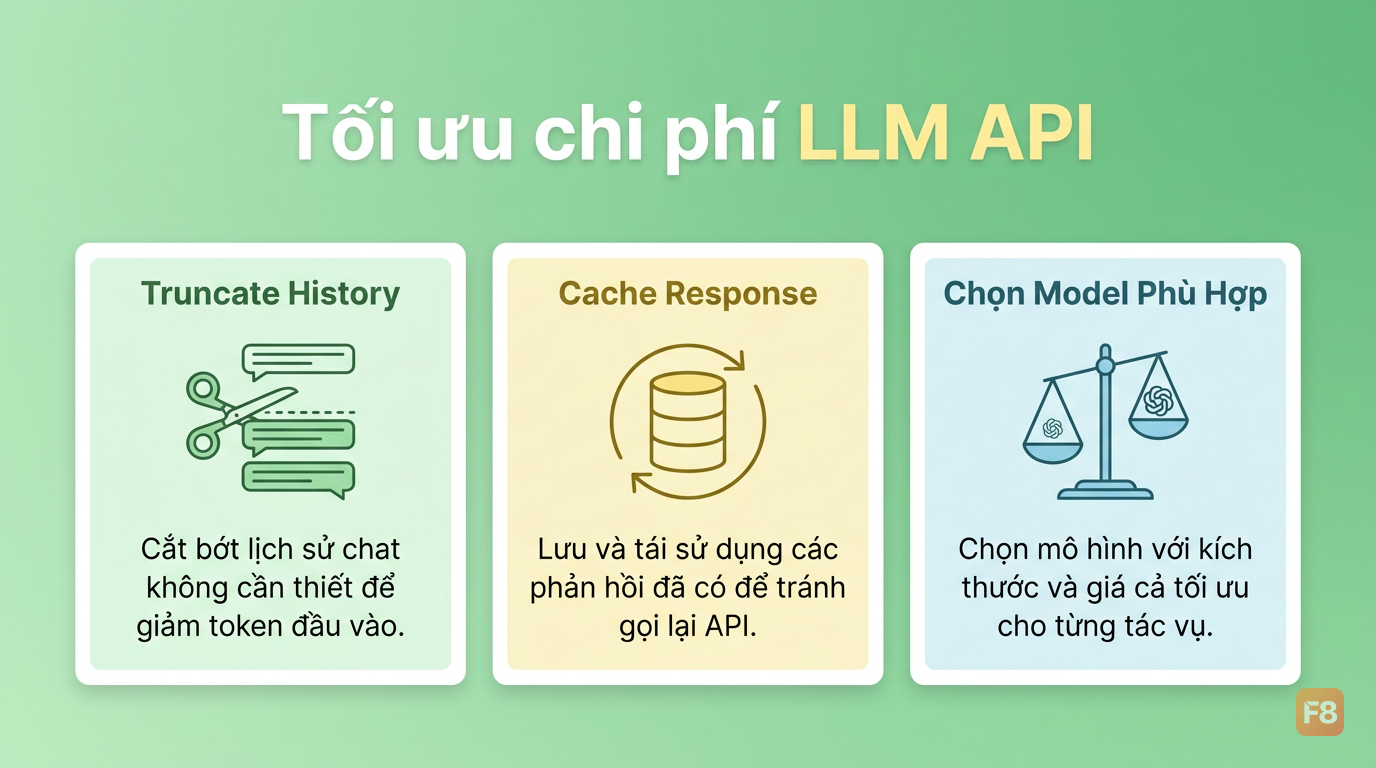
Hóa đơn LLM có thể tăng rất nhanh nếu không kiểm soát. Mình từng thấy project tốn gấp 10 lần cần thiết chỉ vì không cache và không trim conversation history.

Truncate conversation history đúng cách

Nếu giữ toàn bộ conversation history cho mỗi request, chi phí input token tăng tuyến tính theo số lượt chat. Sau 20 lượt, bạn đang gửi 20 message lên API cho mỗi lần user gõ thêm một câu.

// Giữ N message gần nhất + system prompt, bỏ message cũ
function truncateHistory(messages, maxMessages = 10) {
  // Luôn giữ system message đầu tiên (nếu có)
  const systemMessages = messages.filter(m => m.role === 'system');
  const chatMessages = messages.filter(m => m.role !== 'system');

  // Lấy N message gần nhất
  const recentMessages = chatMessages.slice(-maxMessages);

  return [...systemMessages, ...recentMessages];
}

Cache response cho query phổ biến

import { createHash } from 'crypto';

// Cache key từ nội dung request
function getCacheKey(messages) {
  const content = JSON.stringify(messages);
  return createHash('sha256').update(content).digest('hex').slice(0, 16);
}

async function cachedLLMCall(messages, cache, ttlSeconds = 300) {
  const key = `llm:${getCacheKey(messages)}`;

  // Kiểm tra cache trước (Redis hoặc in-memory)
  const cached = await cache.get(key);
  if (cached) return JSON.parse(cached);

  // Gọi API thật nếu cache miss
  const result = await callLLM(messages);
  await cache.set(key, JSON.stringify(result), 'EX', ttlSeconds);

  return result;
}

346885 Cache query phổ biến giảm chi phí đáng kể - FAQ và search thường có pattern lặp lại

Chọn model đúng với task

Không phải task nào cũng cần model mạnh nhất. Phân loại task và dùng model phù hợp:

  • Phân loại intent, routing: model nhỏ/rẻ hơn (GPT-4o mini, Gemini 2.0 Flash)
  • Tóm tắt, extract data: model trung bình
  • Reasoning phức tạp, code review: model mạnh (GPT-4o, Claude 3.5 Sonnet)

Pattern này - gọi là LLM routing - có thể giảm 65% cost reduction by routing 70% of traffic to GPT-4o mini vs using GPT-4o for all requests (OpenAI pricing analysis and LLM routing optimization research) chi phí so với dùng model mạnh nhất cho mọi request.

Trang web dùng cookie để hoạt động và đo hiệu quả quảng cáo. Xem chính sách bảo mật