Tích hợp OpenAI, Claude, Gemini API vào web app: so sánh chi phí, tốc độ và chất lượng
6 giờ tới · 9 phút đọc
Mình đã tốn tiền oan vì chọn sai API
Hồi mình làm chatbot đầu tiên tích hợp AI, mình mặc định chọn GPT-4 cho mọi request. Cuối tháng nhìn hóa đơn: gần $200 cho một app demo có vài chục người dùng. Vấn đề không phải OpenAI đắt - mà mình đang dùng model xịn nhất cho những câu hỏi đơn giản nhất.
Bài viết này không phải "API nào tốt nhất". Không có câu trả lời đó. Mình sẽ chỉ bạn cách setup cả 3, hiểu trade-off thực sự của từng cái, và cuối bài có decision tree để chọn đúng API cho từng use case.
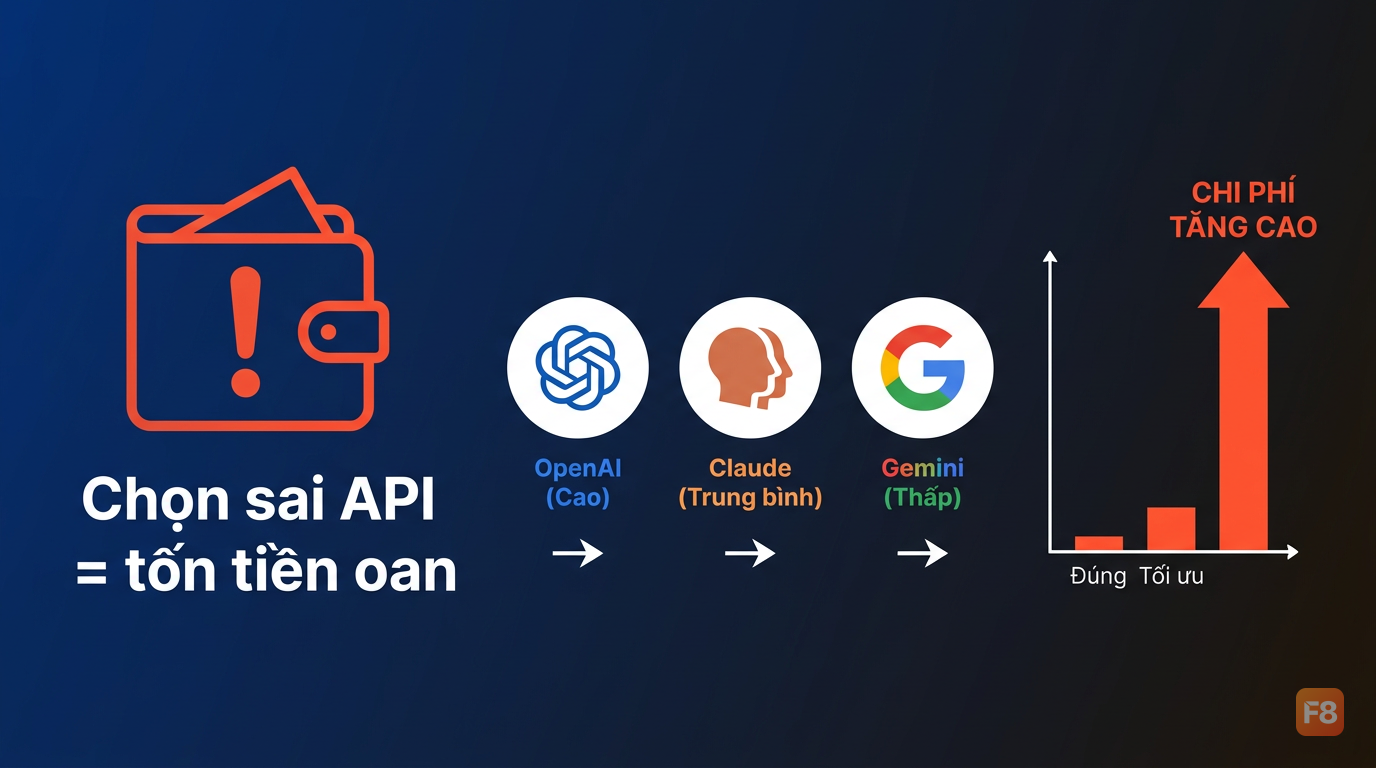 Chi phí thật sự phụ thuộc vào cách bạn dùng, không phải giá niêm yết
Ba nền tảng mình nói đến là OpenAI (GPT-4o, o3...), Anthropic Claude (Haiku, Sonnet, Opus) và Google Gemini (Flash, Pro). Mỗi cái có điểm mạnh riêng, và quan trọng hơn - điểm yếu riêng mà ít ai nói thẳng.
Kiến trúc chuẩn trước khi viết một dòng code nào
Bất kể bạn chọn OpenAI, Claude hay Gemini - kiến trúc đều phải theo một nguyên tắc: API key không được chạm frontend.
User Browser
    ↓ (gửi input)
Backend (Node/Python/...)
    ↓ (giữ API key, gọi AI provider)
OpenAI / Claude / Gemini
    ↓ (trả stream hoặc response)
Backend → Frontend
Lý do đơn giản: nếu key lộ trong JavaScript phía client, ai cũng có thể lấy và dùng quota của bạn. Hóa đơn cuối tháng sẽ rất đẹp theo hướng ngược lại.
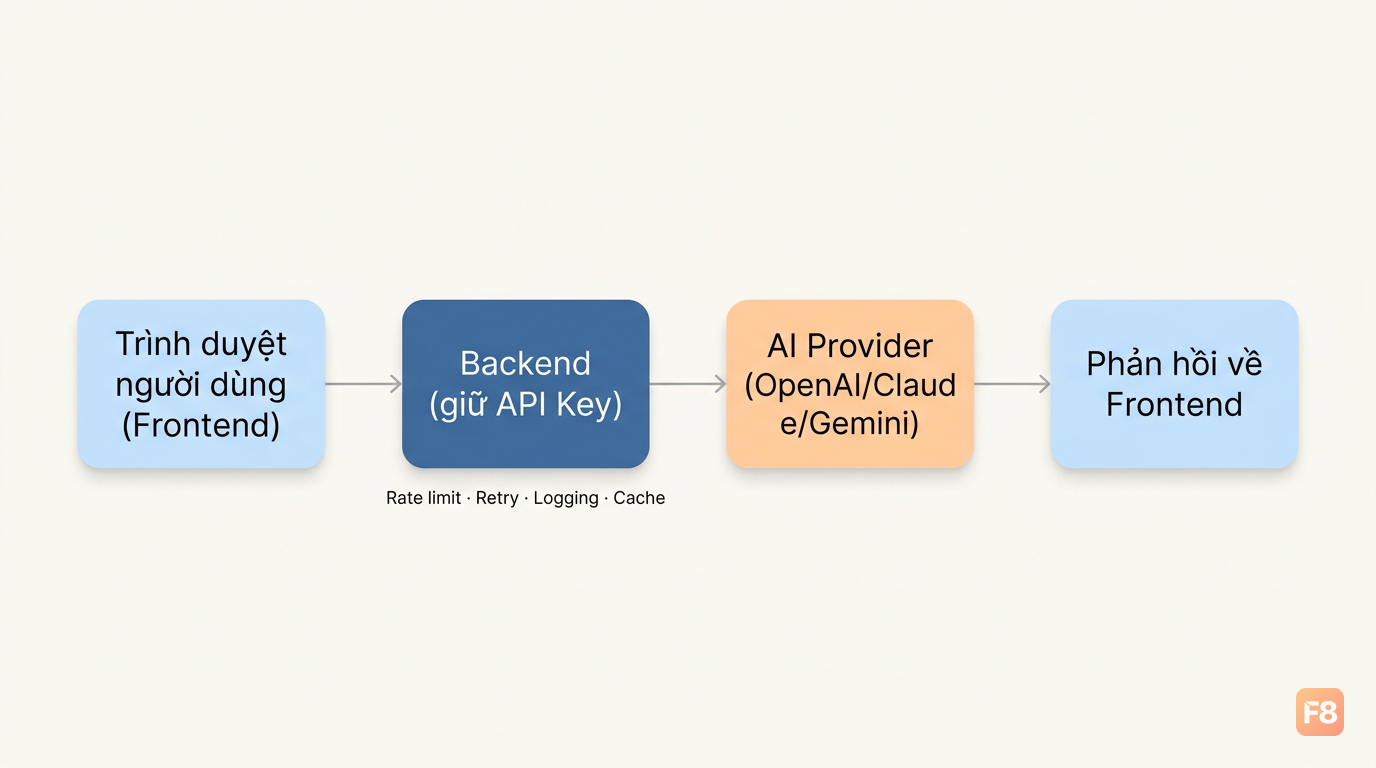 API key phải nằm ở backend - không có ngoại lệ nào cả
Ngoài việc giữ key an toàn, backend cũng là nơi bạn đặt:
- Rate limiting per user: ngăn một người dùng đơn lẻ gọi API ầm ầm
- Retry logic: tự động thử lại khi gặp lỗi 429 hoặc 503
- Token usage logging: biết mình đang tốn bao nhiêu và tốn ở đâu
- Response caching: câu hỏi giống nhau không cần gọi API lại
Mình sẽ code phần này ở Node.js/Express vì đó là stack phổ biến nhất. Nếu bạn chưa quen backend với Node, khóa Node & ExpressJS của F8 cover đủ nền tảng để hiểu phần code bên dưới.
Setup API key và gọi request đầu tiên
Mình đặt cả 3 cạnh nhau cho dễ so sánh. Bắt đầu bằng cấu trúc file:
.env
  OPENAI_API_KEY=sk-...
  ANTHROPIC_API_KEY=sk-ant-...
  GEMINI_API_KEY=AIza...
OpenAI
Claude (Anthropic)
Gemini (Google)
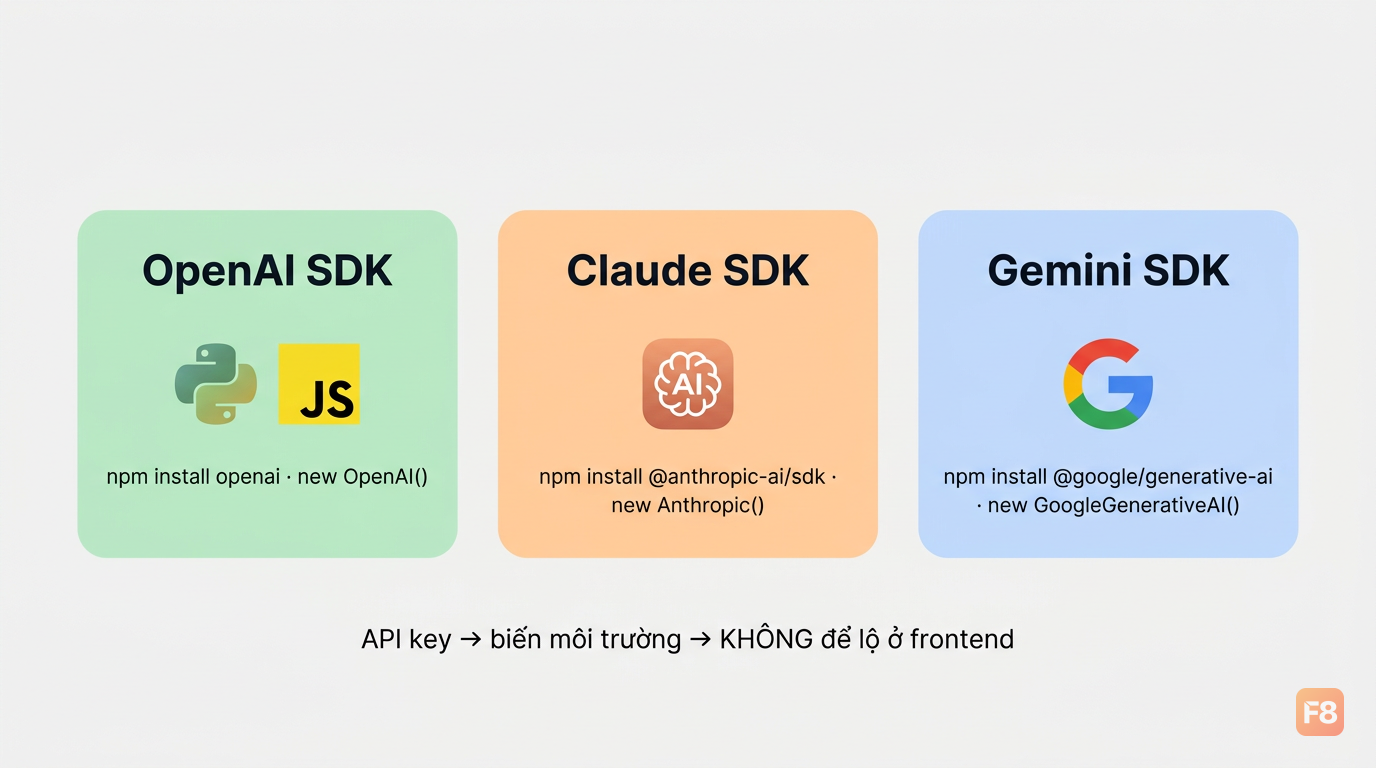 Ba SDK khác nhau nhưng pattern đều giống nhau: init client → gọi API → lấy text
Lưu ý nhỏ: Gemini có API key miễn phí với rate limit nhất định qua Google AI Studio - khá tiện để thử nghiệm ban đầu mà không tốn tiền.
Streaming responses: cách làm chatbot "gõ từng chữ"
Không streaming = người dùng chờ đến khi model xử lý xong mới thấy kết quả. Với câu trả lời dài, đó có thể là 5-10 giây im lặng hoàn toàn. Trải nghiệm đó tệ.
Streaming giải quyết bằng cách trả về từng token ngay khi model tạo ra. UI cập nhật liên tục, người dùng thấy phản hồi ngay lập tức.
Mình sẽ implement với SSE (Server-Sent Events) - đơn giản hơn WebSocket cho use case one-direction stream:
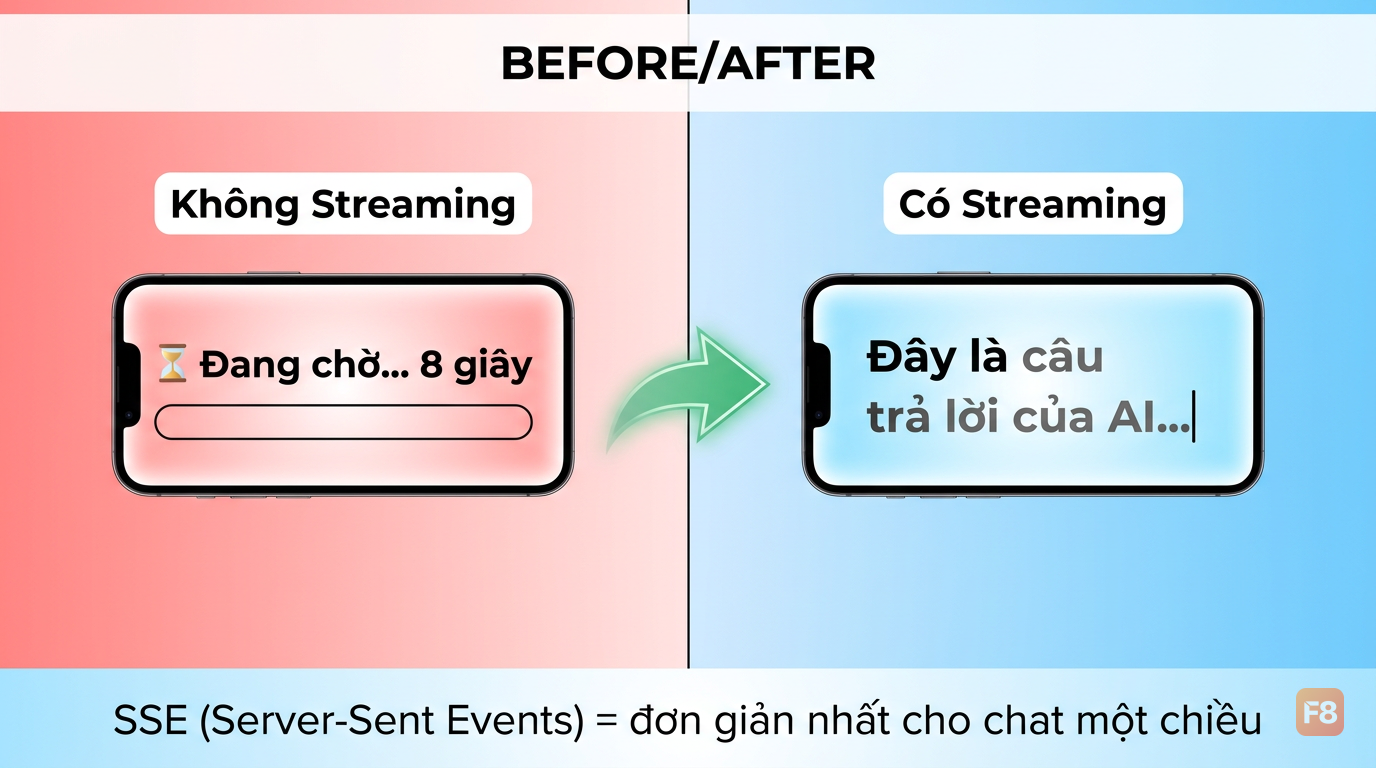 Streaming biến "chờ 8 giây" thành "thấy chữ ngay từ giây đầu tiên"
Phía frontend, bạn đọc stream bằng EventSource hoặc fetch với ReadableStream. Mình không đi sâu vào đây vì phần frontend khá chuẩn - search "fetch SSE javascript" là ra pattern cụ thể.
Error handling và rate limiting đúng cách
Gọi AI API trong production mà không có retry logic thì đảm bảo app sẽ crash vào lúc tệ nhất. Mình từng học bài học này theo cách cứng nhất.
Các lỗi bạn sẽ gặp thường xuyên:
- 429 (Rate Limit): gọi quá nhiều trong thời gian ngắn - cần retry sau vài giây
- 503 (Service Unavailable): provider đang quá tải - retry có ích
- 401/403: sai key hoặc hết quota - retry vô nghĩa, cần alert ngay
- Timeout: prompt quá dài hoặc mạng có vấn đề
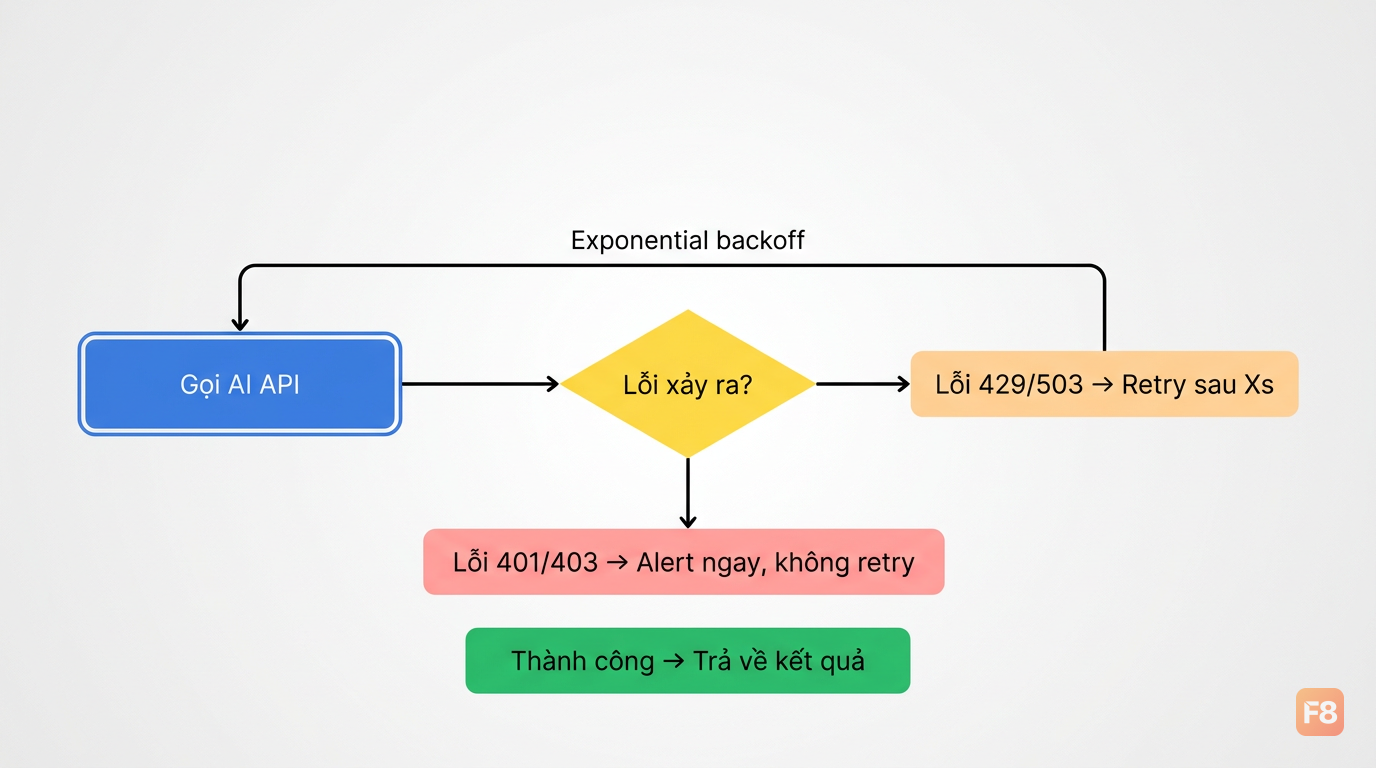 Retry logic đơn giản nhưng tránh được phần lớn downtime không đáng có
Với production app có nhiều user, nên dùng Redis thay vì in-memory Map cho rate limiting. In-memory không persist khi server restart và không hoạt động với multi-instance deployment.
So sánh chi phí, tốc độ và chất lượng
Mình sẽ không nói "API X tốt nhất" vì câu đó vô nghĩa nếu tách khỏi context. Thay vào đó, đây là bảng so sánh theo tiêu chí thực tế.
Lưu ý quan trọng: giá API thay đổi liên tục. Số liệu dưới đây dựa trên thông tin tổng hợp gần đây - luôn đối chiếu lại trang pricing chính thức trước khi deploy production.
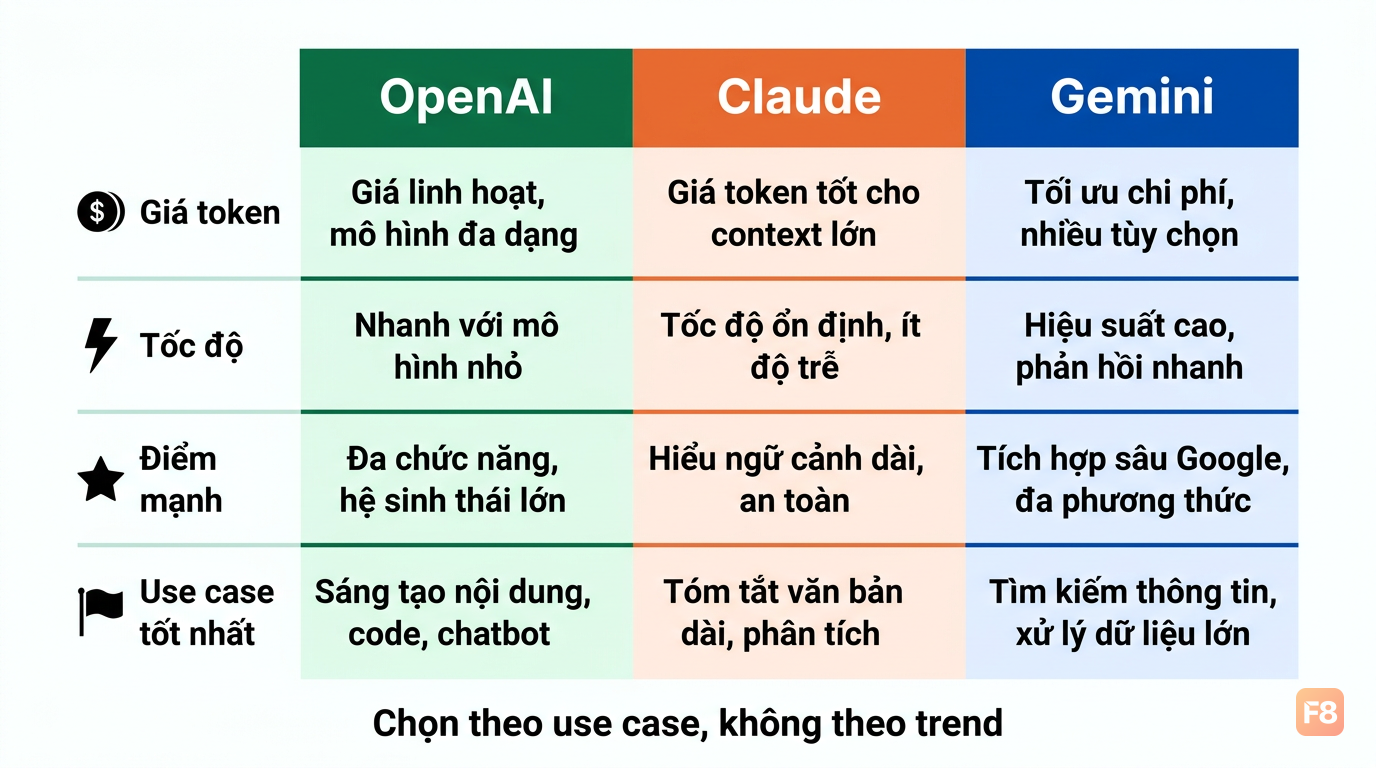 So sánh theo use case cụ thể quan trọng hơn so sánh chung chung
| Tiêu chí | OpenAI (gpt-4o-mini) | Claude (Haiku 4.5) | Gemini (2.5 Flash) |
|---|---|---|---|
| Input price | $0.15 per 1M tokens (input price for gpt-4o-mini) (OpenAI Official Pricing) | ~$1/1M tokens | ~$0.10-0.30/1M tokens |
| Output price | $0.15 per 1M input tokens and $0.60 per 1M output tokens (OpenAI API Pricing) | ~$5/1M tokens | ~$0.40-2.50/1M tokens |
| Context window | {{fact:2}} | ~1M tokens | Rất lớn (xem docs) |
| Streaming | Tốt | Tốt | Tốt |
| Tool calling | Rất mạnh | Mạnh | Mạnh |
| Điểm mạnh | Đa dụng, hệ sinh thái | Viết lách, phân tích dài | Context dài, Google ecosystem |
| Free tier | Không (trả pay-per-use) | Không | Có qua AI Studio |
Theo use case
Chatbot phổ thông: OpenAI gpt-4o-mini hoặc Gemini Flash. Rẻ, nhanh, đủ tốt.
Content generation chất lượng cao: Claude Sonnet. Văn phong tự nhiên hơn, giữ giọng văn tốt hơn trong output dài.
Code review/analysis: Claude hoặc OpenAI - cả hai đều mạnh. Claude có lợi thế khi cần phân tích toàn bộ repository dài.
Xử lý tài liệu dài (>100K tokens): Gemini hoặc Claude - cả hai hỗ trợ context window cực lớn.
Tool calling phức tạp (AI agent): OpenAI - hệ sinh thái và documentation cho agentic workflow hoàn thiện nhất hiện tại.