Vibe Coding 2026: Dùng Cursor, Claude Code, GitHub Copilot sao cho nhanh mà không lỗi
2 ngày trước · 10 phút đọc
Vibe coding là gì, và tại sao cần guardrails
Mình đã từng nghĩ vibe coding nghĩa là gõ ít đi, để AI lo phần còn lại. Hai tuần sau, mình nhận ra mình đang spend phần lớn thời gian debug code mà mình không thực sự đọc. Không phải AI tệ. Mình dùng sai.
Vibe coding - theo nghĩa tử tế hơn - là workflow để AI xử lý phần cơ học của code (scaffold, boilerplate, viết test, chuyển đổi format), còn bạn giữ quyết định ở những chỗ thật sự quan trọng: kiến trúc, security, edge cases, và trade-off.
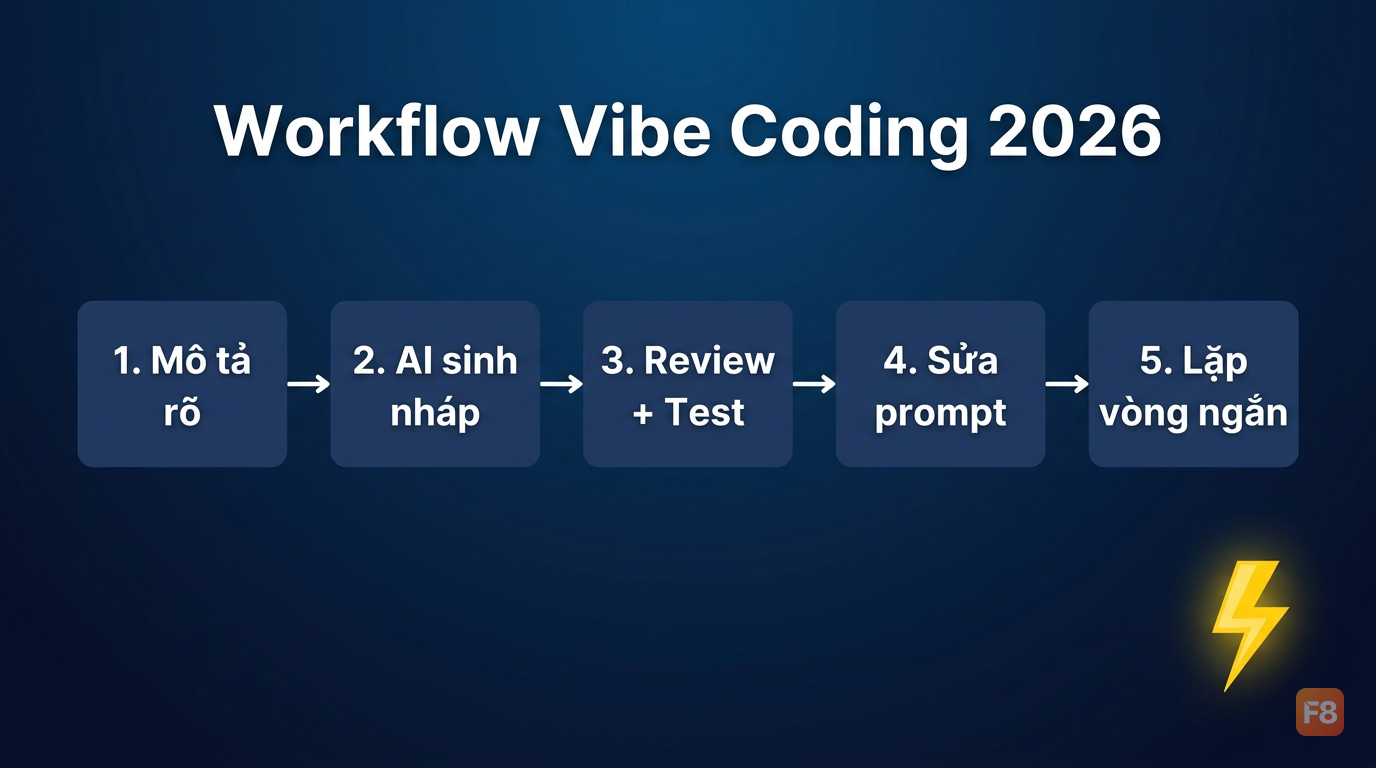 AI lo phần cơ học, bạn lo phần tư duy - đó là phân công hợp lý
Vấn đề không phải là AI có viết đúng không. AI viết nhanh lắm. Vấn đề là bạn có đủ guardrails để biết khi nào nó viết sai không.
Workflow chuẩn nhất hiện tại trông như này:
- Mô tả rõ yêu cầu (bao gồm ràng buộc và điều cấm)
- AI sinh nháp
- Review bằng mắt + chạy test/lint/typecheck
- Sửa prompt hoặc context nếu cần
- Lặp lại - nhưng với vòng lặp ngắn, không phải batch lớn
Giữ nhịp này, bạn có thể đạt 2-3x nhanh hơn mà không cần đổi chất lượng lấy tốc độ. Bỏ nhịp này, bạn đang chạy nhanh về phía technical debt.
Cách viết prompt không bị AI 'bịa'
Prompt mơ hồ là nguyên nhân số một khiến AI sinh code nhìn đúng nhưng chạy sai. Mình từng viết 'thêm validation cho form đăng ký' và nhận lại một đống code validate ở frontend trong khi mình cần ở backend.
Prompt tốt cho coding assistants cần 6 phần:
- Mục tiêu cụ thể: "Viết hàm X để làm Y"
- Ngữ cảnh: framework, version, patterns đang dùng
- Ràng buộc: không đổi public API, không thêm dependency, giữ backward compatibility
- Đầu ra mong muốn: file nào, format nào, cần test nào
- Tiêu chí chấp nhận: pass test, không warning lint, cover edge cases
- Điều cấm: không tạo placeholder, không giả định schema, không xóa code cũ nếu chưa hỏi
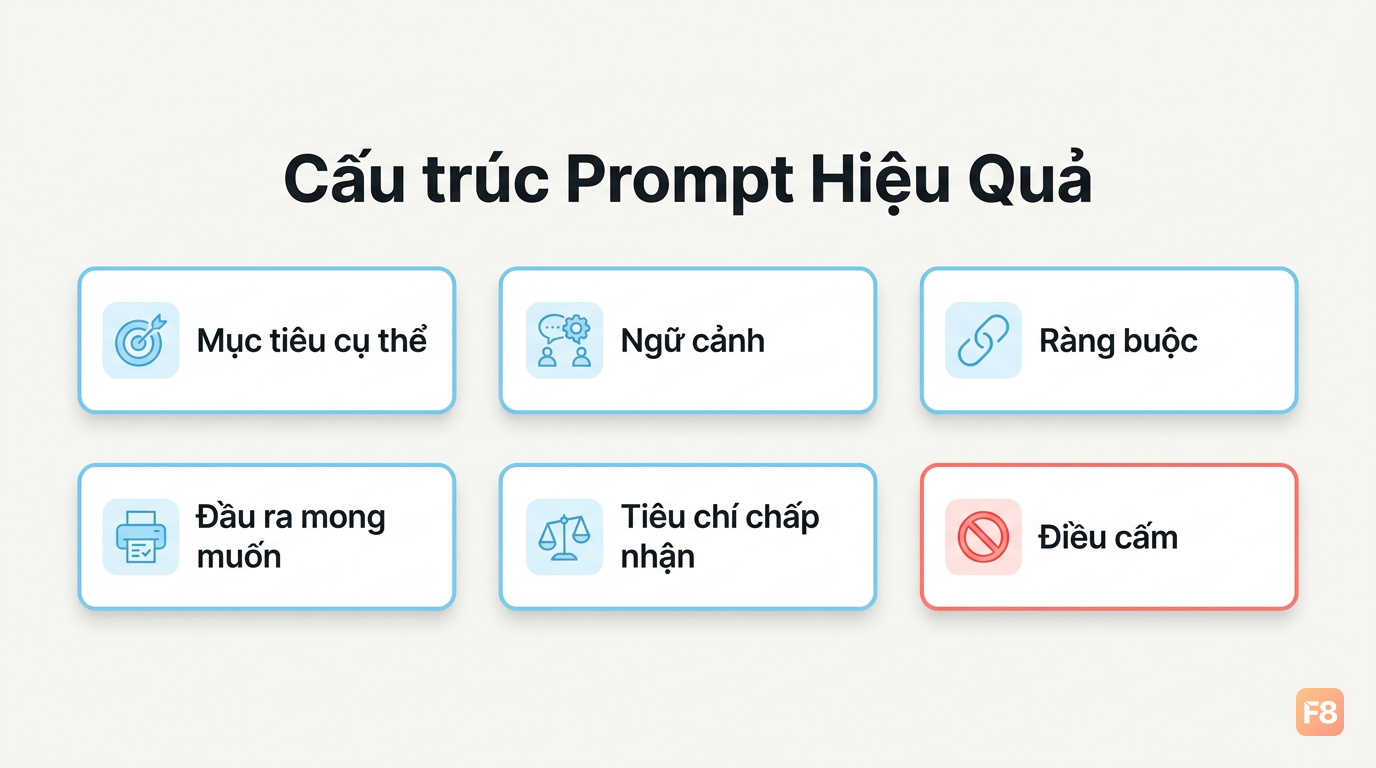 6 thành phần này phân biệt prompt tốt và prompt gây ra 2 giờ debug
Một ví dụ thực tế:
Cái "trả về diff tối thiểu" quan trọng hơn bạn nghĩ. AI không có incentive để code ít - nếu bạn không chỉ định, nó sẽ viết thêm, refactor thêm, và bạn sẽ phải review nhiều hơn cần thiết.
Một trick khác: với task khó, yêu cầu AI đưa ra 2-3 phương án trước khi code. Điều này tránh việc bạn review xong mới nhận ra mình đã đi sai hướng từ đầu.
Setup context để AI ít 'hallucinate'
AI không đọc được tâm trí bạn, và cũng không đọc được toàn bộ codebase của bạn. Context kém là lý do AI recommend patterns không phù hợp, thêm dependency không cần thiết, hoặc viết code mâu thuẫn với style hiện có.
Một số quy tắc mình đang dùng:
Chỉ đưa file liên quan trực tiếp. Ném cả repo vào context không giúp ích - nó khiến AI loãng tập trung và tốn token. Chọn đúng 2-5 file thực sự liên quan.
Dán style guide và lint rules nếu AI không tự đọc được. Không phải tool nào cũng index được toàn bộ config của bạn. Nếu bạn có ESLint rules hay naming convention nội bộ, paste thẳng vào.
Chia task lớn thành bước nhỏ. Thứ tự tốt: khảo sát code → đề xuất plan → implement → test → polish. Đừng skip bước "đề xuất plan" - đây là nơi bạn bắt sai ngữ cảnh sớm nhất.
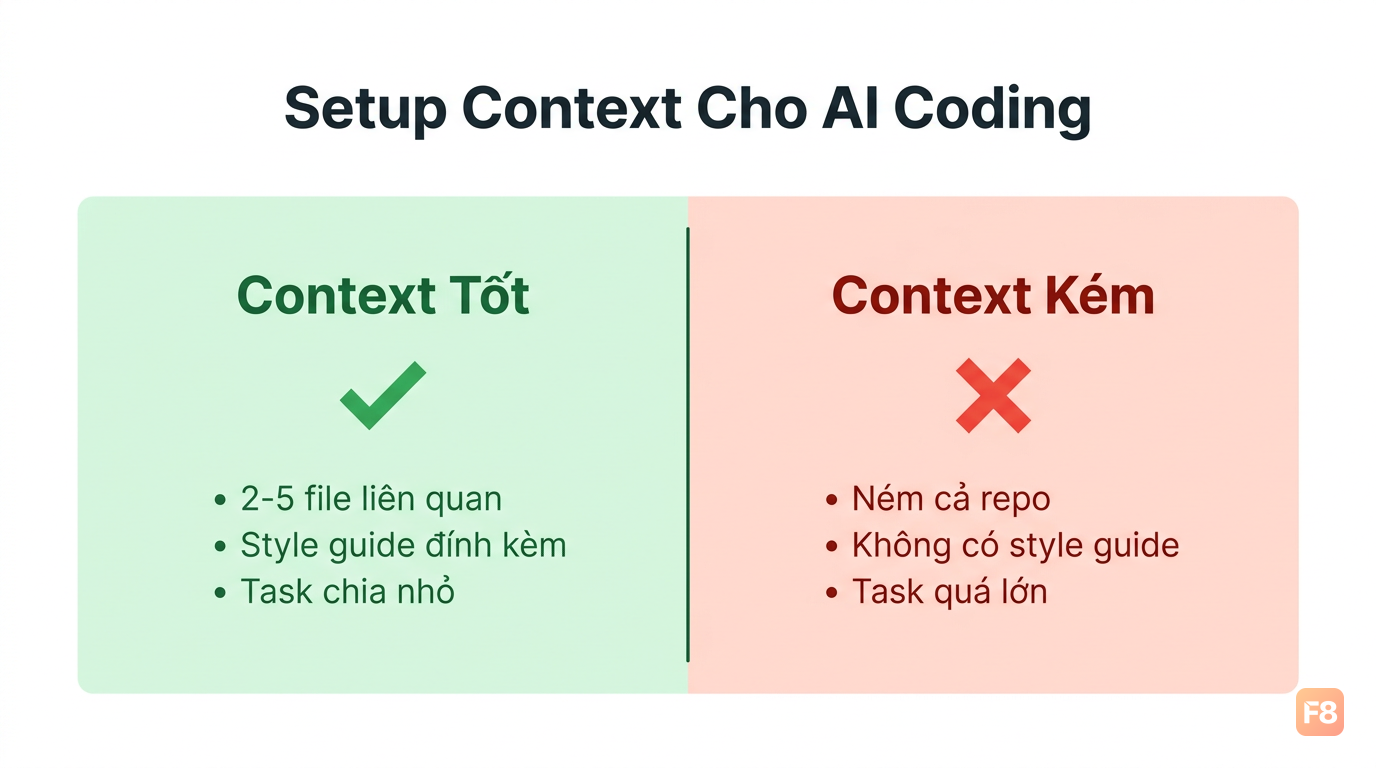 Context đúng = AI hiểu đúng. Thiếu context = AI đoán và đoán sai
Yêu cầu AI tóm tắt hiểu biết trước khi sửa code. Câu mình hay dùng: "Trước khi implement, hãy tóm tắt ngắn gọn những gì bạn hiểu về codebase này và plan của bạn." Nếu tóm tắt sai, mình sửa ngay thay vì chờ đến khi code xong.
Một source of truth cho spec. Nếu mỗi chat session bạn mô tả yêu cầu một kiểu khác, AI sẽ tạo ra code không nhất quán. Giữ spec ở một chỗ, paste vào mỗi lần cần.
Review code từ AI: đọc theo 5 lớp
Chấp nhận diff lớn không đọc là anti-pattern nguy hiểm nhất khi dùng AI coding tools. Mình thấy mình làm điều này nhiều nhất vào cuối ngày khi đang rush deadline - và đó cũng là lúc bug lọt vào production nhiều nhất.
Review code từ AI theo thứ tự này:
Lớp 1 - Đúng yêu cầu chưa? Code có làm đúng điều bạn yêu cầu không? Đây là câu hỏi đơn giản nhất nhưng hay bị skip nhất.
Lớp 2 - Có phá gì không? Có đổi API contract, data model, hay flow hiện tại không? AI đôi khi refactor thêm những thứ bạn không yêu cầu.
Lớp 3 - Bug tiềm ẩn. Race condition, null handling, off-by-one error, missing await - những thứ AI viết trông ổn nhưng fail ở edge case.
Lớp 4 - Test có thật sự bắt được lỗi không? AI hay viết test pass 100% nhưng không test được gì. Check xem assertion có meaningful không.
Lớp 5 - Code thừa. Có đẹp nhưng over-engineered không? Có import thừa, helper không dùng, comment lỗi thời không?
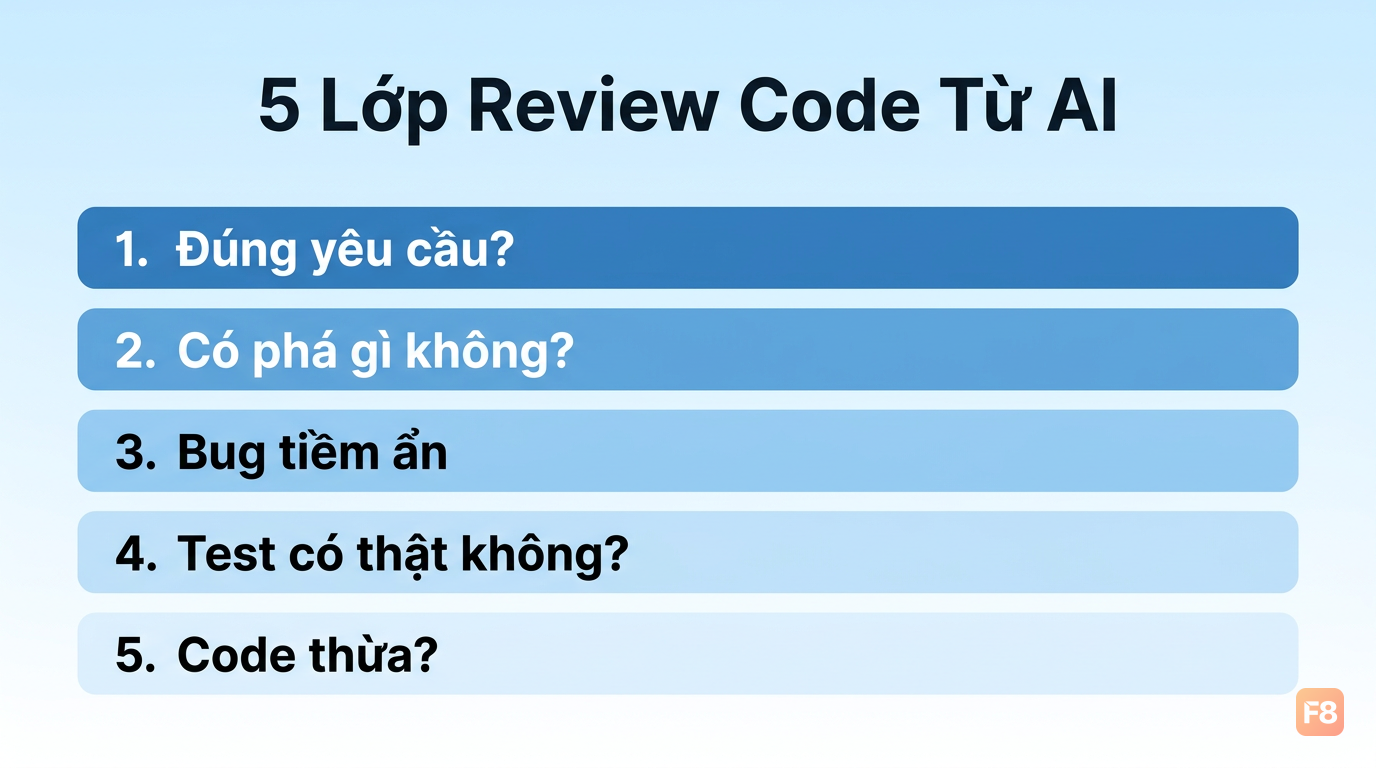 5 lớp review - bỏ lớp nào cũng có thể gây ra bug khác nhau
Checklist nhanh khi review:
- [ ] Tên biến/hàm có rõ không
- [ ] Có xử lý error paths không
- [ ] Có side effect ngoài dự kiến không
- [ ] Có hardcode hoặc magic number không
- [ ] Test, docs, migration, config đã cập nhật chưa
Khi diff quá lớn (hơn 200 dòng thay đổi), mình thường yêu cầu AI break nhỏ ra thành nhiều PR thay vì review một lúc. Không phải vì lười - mà vì đọc 500 dòng diff một lúc thì não không còn đủ tỉnh để bắt bug lớp 3 và lớp 4.
Guardrails: những thứ không để AI tự quyết
AI rất giỏi tạo tốc độ. Nhưng tốc độ không có guardrails thì chỉ là cách tạo technical debt nhanh hơn.
Bắt buộc tự động hóa những cái này:
- Test tự động cho mọi logic mới do AI tạo
- Lint và typecheck trước khi merge (CI block nếu fail)
- Pre-commit hook để format và catch obvious issues
- Secret scanning để AI không vô tình để lộ credential trong code
- Dependency scan khi AI suggest thêm package mới
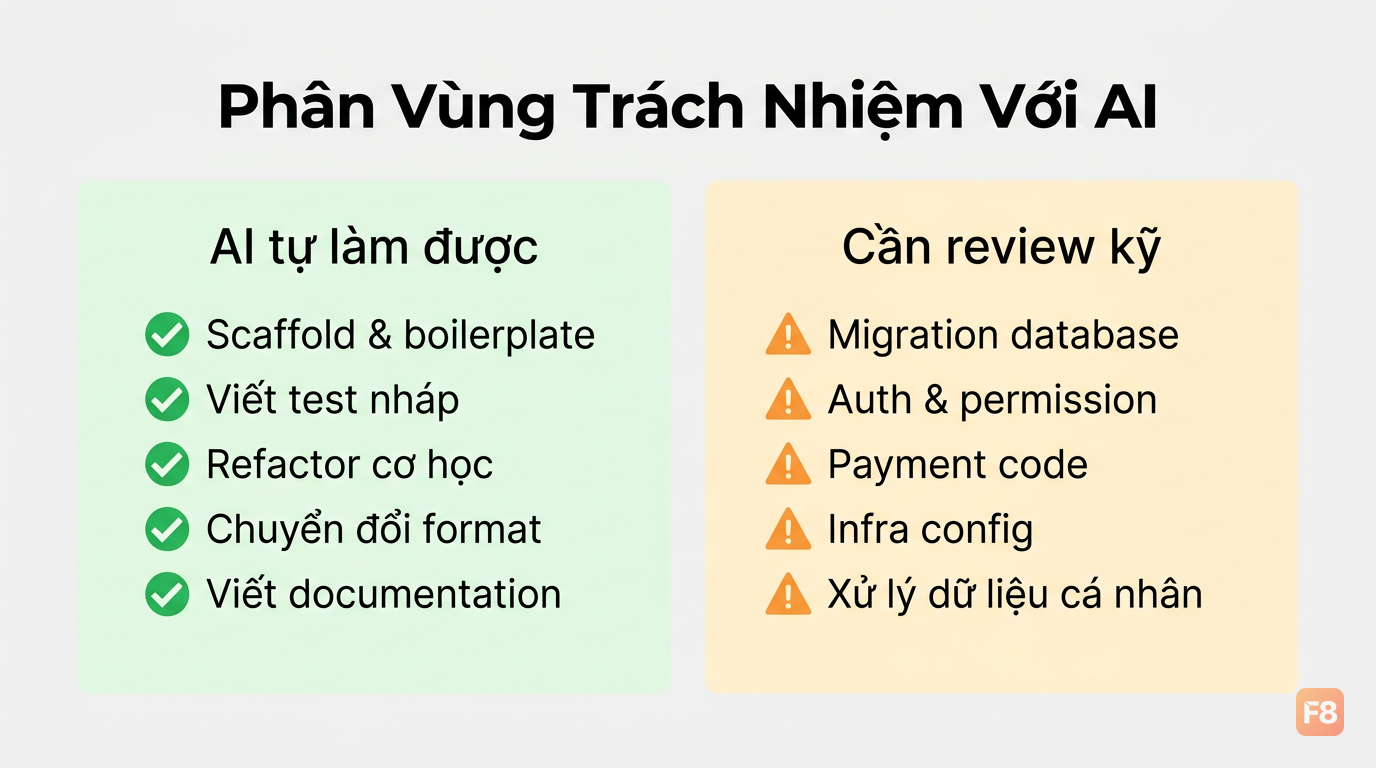 Guardrails không làm bạn chậm lại - chúng ngăn bạn chạy về hướng sai
Những thứ không cho AI tự sửa mà không có review người thật:
- Migration database
- Auth và permission logic
- Payment và billing code
- Infra và deployment config
- Code xử lý PII (thông tin cá nhân)
Với những thứ này, không phải là "AI không được chạm vào" - mà là "AI tạo draft, nhưng phải có người review kỹ trước khi merge". Yêu cầu AI giải thích cả "why" và "risk" khi suggest thay đổi ở những vùng nhạy cảm này.
Một rule mình áp dụng cho team: bất kỳ diff nào do AI tạo ra đều phải pass test tự động và được ít nhất một người đọc qua. Không có exception, kể cả hotfix lúc 2 giờ sáng.
Với code ảnh hưởng hiệu năng, chạy benchmark hoặc smoke test trước khi merge. AI hay tối ưu micro-level nhưng vô tình tạo bottleneck ở chỗ khác.
So sánh thực tế: Cursor, Claude Code, và GitHub Copilot
Ba tool này không phải đối thủ của nhau theo nghĩa thông thường - chúng giải quyết ba kiểu workflow khác nhau. Chọn sai tool không làm bạn chậm đôi chút, nó có thể làm bạn chậm đôi chút mỗi ngày trong nhiều tháng.
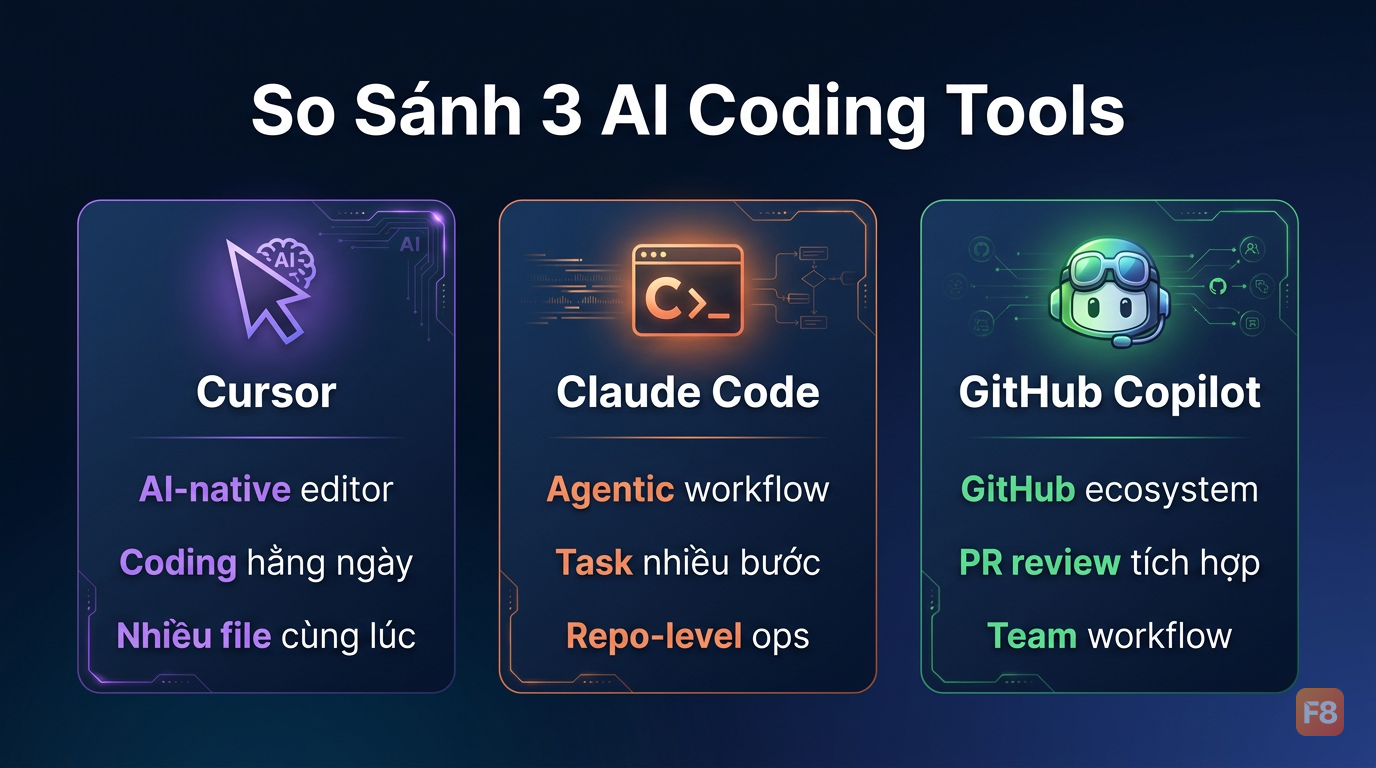 Ba tool, ba use case - không có cái nào 'tốt nhất' tuyệt đối
Cursor là AI-native editor. Điểm mạnh nằm ở việc bạn có thể sửa nhiều file cùng lúc, iteration nhanh trong editor, và context đọc codebase khá tốt. Phù hợp nhất khi bạn muốn tăng tốc coding hằng ngày và không muốn chuyển đổi context ra ngoài IDE. Điểm yếu: nếu review lỏng, giao diện "Accept diff" trực quan có thể khiến bạn approve code chưa đọc kỹ.
Claude Code là agentic terminal workflow - bạn giao task theo kiểu "hãy refactor module X và viết test", và nó làm nhiều bước tự động. Phù hợp với task lớn hơn, repo-level operation, và những lúc bạn muốn kết quả theo kiểu "báo cáo lại khi xong". Cần quy trình chặt hơn để tránh nó làm thay đổi ngoài scope.
GitHub Copilot tích hợp sâu nhất vào GitHub ecosystem: completions, chat, PR review, và workspace context. Nếu team bạn đã sống trong GitHub - PRs, Actions, issues - Copilot là lựa chọn tự nhiên nhất vì không cần thay đổi workflow. Từ tháng 6/2026, GitHub Copilot đã chuyển sang usage-based billing với Copilot Business ở mức $19 per user per month with $19 in monthly GitHub AI Credits included (GitHub Official Announcement) kèm AI credits hàng tháng.
| Tool | Tốt nhất cho | Trade-off chính |
|---|---|---|
| Cursor | Coding hằng ngày trong editor | Dễ approve diff không đọc kỹ |
| Claude Code | Task nhiều bước, repo-level | Cần scope chặt, tránh over-reach |
| GitHub Copilot | Team trong GitHub ecosystem | Pricing thay đổi theo usage |
Không có câu trả lời "dùng cái nào". Mình đang dùng cả ba tùy context: Cursor cho daily coding, Claude Code cho refactor lớn, Copilot khi review PR trong GitHub.